AIエージェントのユースケースは、部門ごとにほぼ形が決まっています。マーケティングの月次レポート、営業の名刺処理とフォロー、カスタマーサポートの一次対応、バックオフィスの経費精算。どれも、人が人に依頼して結果を待つ時間が工程の中に残っている業務です。
生成AIを全社に配っても、部門をまたいだ仕事の日数は縮みません。資料を書く工程は速くなりますが、依頼して、完成を待ち、修正をやり取りする前後の工程がそのまま残るためです。目的だけを渡せば手順を自ら決めて実行するAIエージェントは、この待ち時間を対象にしています。
AIエージェント(AI Agent)とは、目的を与えられると、その達成に必要な手順を自ら組み立て、必要なツールを呼び出し、結果を確認して次の行動を選ぶAIのことです。人が質問して初めて動く生成AIとは、動き出す起点が違います。
評価の対象になるのは回答の賢さではありません。どこまでを機械に任せ、どこから人が承認し、失敗したときに誰が止めるのかを、自社で決められるかどうかです。この記事では次の順序で整理します。
- ユースケース:部門別12例と、業界ごとに変わる重心
- 生成AIとの違い:応答するAIと、目的から逆算して実行するAIの差
- 仕組みと5つのタイプ:知覚、推論、行動、学習の4段階と、自律性の段階
- 基盤の選び方:自社の業務データがどこにあるかで決まる
- リスクとガバナンス:事故をゼロにするのではなく、1時間で止められる設計にする
- 進め方:4つのフェーズと、PoCを正解率で判定しない3つの基準
AIエージェントとは。目的を渡せば手順を自ら決めて実行するAI
AIエージェントは、目的の入力から結果の検証までを人の起点なしに回します。生成AIと同じ大規模言語モデルを基盤としながら、業務での役割が根本的に異なるのはこのためです。
生成AIとの違いは、次の一手を誰が決めるか
生成AIの役割は、人の指示に応答することです。文章作成を依頼すればテキストが返ってきますが、その結果をどう使うか、次に何をするかの判断は人が下します。人が指示を止めれば、処理もそこで止まります。
AIエージェントは、目的だけを受け取って手順を分解します。月次のマーケティングレポートを例にすると、違いははっきりします。生成AIに「先月の施策の結果をまとめて」と依頼した場合、返ってくるのは社内ドキュメントに書かれている内容の要約です。広告管理画面やCRMの実データは参照していないため、数字の信頼性は担当者が別途確認することになります。
同じ目的をAIエージェントに渡すと、広告管理画面にアクセスし、CRMから顧客データを取得し、両者を突き合わせて分析します。想定した仮説が外れれば、条件を変えて再度調べます。出てくるのは整理された文章ではなく、データで裏づけた結論です。この考え方の背景はAgentic AIが注目される理由で詳しく扱っています。
この差は、業務フローの設計単位にも及びます。生成AIが短縮するのは工程の内側です。AIエージェントは、依頼と待ちを含めて一つのタスクとして処理するため、工程と工程の間にある時間を縮めます。
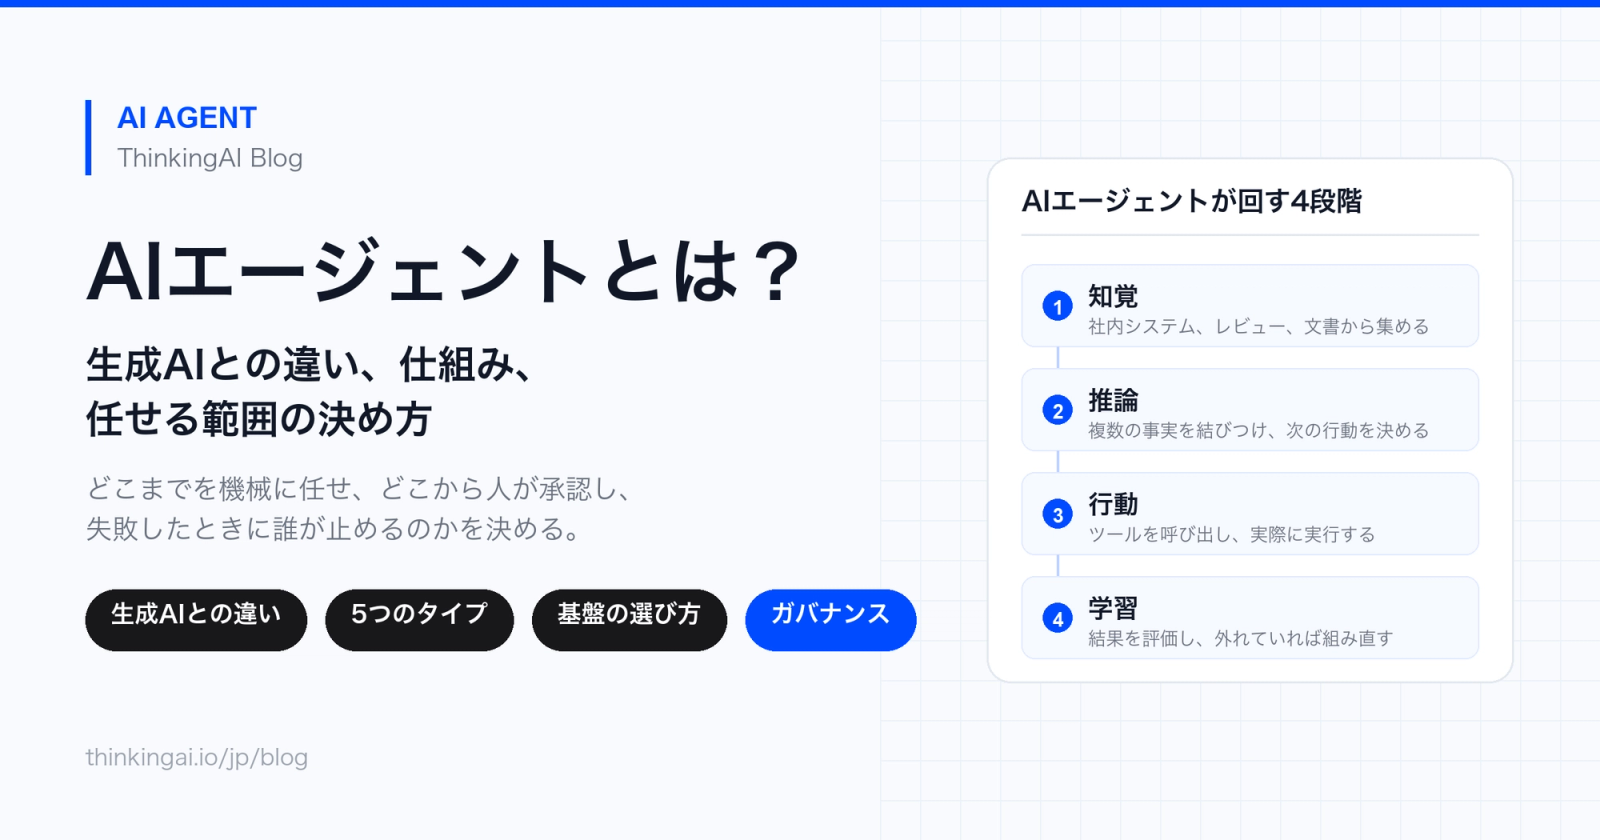
知覚、推論、行動、学習の4段階で動く
AIエージェントが自律的に動けるのは、4段階のサイクルを連続して回しているためです。
一つ目は知覚です。社内システムへのアクセス、Webサイトからのデータ取得、メールやドキュメントの読み込みを通じて、目的の達成に必要な情報を集めます。広告管理画面のクリック数、CRMの顧客属性、過去のメール履歴といった複数のソースを横断します。ユーザーの声やレビューのような文章のままのデータをどう扱うかは、SNS感情分析とは?KPIより先に動く読み方、日本語の誤判定、ツール選定の基準で整理しています。
二つ目は推論です。集めた情報を分析し、複数の事実を組み合わせて状況を把握したうえで、次の行動を決めます。推論の質は基盤となる大規模言語モデルの能力に依存しますが、参照できるデータの範囲と、事前に定義された判断基準によっても変わります。
三つ目は行動です。メールの送信、データベースへの書き込み、APIの呼び出し、社内ワークフローの起動といった、人が手を動かしていた操作を実行します。複数の選択肢から使うツールを選び、その使い方も自ら決める点が、逐一の指示を不要にしています。
四つ目は学習です。実行した結果が目的の達成に適切だったかを評価し、期待と違えば推論に立ち戻って別の手順を試します。最初の検索条件で必要なデータが得られなければ、条件を変えて再実行するといった修正が自動で行われます。
管理する側から見ると、このサイクルには確認のしやすさという利点があります。どのシステムにいつアクセスして何を取得したか、どのような判断で次に進んだか、どこで失敗して修正したかが、すべて実行ログに残るためです。確認するのは結論ではなく経路の妥当性で、これは部下の仕事の進め方を確認する作業と変わりません。
失敗の仕方が違う。生成AIは埋め、AIエージェントは止まる
実務では、失敗したときの挙動の差が効いてきます。生成AIは情報がない状況でも、それらしい文章で空白を埋めます。一見正確に読めるのに根拠のない記述が混ざるため、業務に組み込むと確認の負荷が残ります。
AIエージェントがツールの呼び出しに失敗した場合は、その場で停止するか、エラーとして記録されます。処理は完結しませんが、どこで止まったかが特定できるため、現場では対応しやすくなります。
12のユースケースを、1つの基盤で回す形
知覚から実行までを自律的に回す仕組みと、権限設計、運用体制を製品紹介資料にまとめています。
AIエージェントのユースケース12選。部門別の活用例と、自社がどこから始めるか
ユースケースは部門ごとにほぼ決まっていて、どの部門でも、人が人に依頼して結果を待つ工程が対象になります。先に12例を部門別に挙げ、そのあと業界ごとの違いと、効果が消える条件を扱います。かっこ内は、人が承認する箇所です。
- マーケティング:月次レポートの作成と要因分解(公開前の数値確認)
- マーケティング:キャンペーンの配信設計と改善(配信の実行)
- 営業:展示会で獲得した名刺の処理とフォロー(優先度の高い案件の文面)
- 営業:既存顧客への次のアクションの提案(提案内容と送付)
- カスタマーサポート:問い合わせの一次対応と返送手配(例外案件の引き取り)
- カスタマーサポート:対応履歴からのFAQ更新(公開の判断)
- バックオフィス:経費精算と出張申請の審査(規定外の申請)
- バックオフィス:契約書・請求書の内容確認(相違があった項目)
- 製造・サプライチェーン:発注量と時期の判断(発注の実行)
- 製造・サプライチェーン:サプライヤー契約条件の照合(条件変更の交渉)
- データ分析・経営企画:KPIの変動要因の分解(結論の採用)
- データ分析・経営企画:部門横断の会議資料の生成(前提の確認)
マーケティング:月次レポートの作成と、キャンペーンの配信設計
月次レポートの作成は、最も早く成立するユースケースです。広告管理画面にアクセスし、CRMから顧客データを取得し、両者を突き合わせ、想定した仮説が外れれば条件を変えて再度調べるところまでが一続きで動きます。担当者が受け取るのは文章の要約ではなく、データで裏づけた結論です。
キャンペーンの配信設計と改善も同じ型です。配信対象の抽出、訴求内容の案出し、実施タイミングの判断までを実行し、結果を見て次の条件を変えます。広告やキャンペーンの運用でどこまで任せられるかは、AIエージェントは、アプリキャンペーン運用の何を変えるのかで具体的に扱っています。
営業:名刺の処理から個別フォローまでと、既存顧客への次のアクション
展示会で獲得した名刺の処理は、効果が分かりやすいユースケースです。名刺300枚を人が処理する場合、スキャンしたデータの表記ゆれを直し、CRMで重複を確認し、役職から優先度を仕分け、ブースでの会話メモを参考に個別の文面を作成するまでに1週間程度かかります。その間に相手は他社の提案を受けているため、反応率は下がります。
AIエージェントに名刺データを渡すと、CRMの検索による重複判定、会社情報の取得、役職から決裁への距離の評価、会話内容に基づく文面の生成までが続けて実行されます。優先度の高い案件だけ担当者が内容を確認して修正し、残りは送信の操作だけで完了します。
既存顧客への次のアクションの提案も、営業部門で成立します。購買履歴、業界のニュース、自社の在庫状況を組み合わせて提案内容を生成し、担当者は内容を確認して調整します。一斉送信で済ませていた営業メールを、顧客ごとの購買履歴や業界背景に基づいて個別に作成する、といった形です。工数削減よりも、この質の変化のほうが顧客側の体験に影響します。
カスタマーサポート:問い合わせの一次対応と、対応履歴からのFAQ更新
問い合わせの一次対応では、内容を理解し、該当する製品情報を検索し、返品ポリシーを確認して返送手配まで進める運用が可能になります。複雑な例外のみ人が引き取る形です。
対応履歴からのFAQ更新は、同じ質問が繰り返されている箇所を抽出し、既存のFAQとの差分を出すところまでを任せます。更新を公開まで任せるかどうかは、その行動を取り消せるかどうかで判断します。
バックオフィス:経費精算の審査と、契約書・請求書の内容確認
経費精算と出張管理は、手順が固定されているため早く立ち上がります。従業員が経費情報を送れば、領収書を確認し、会計科目を判定し、承認ルートに応じた処理まで実行されます。
契約書と請求書の内容確認では、金額、期間、支払条件が申請内容と一致しているかを照合し、相違がある項目だけを担当者に上げます。全件を人が読む運用から、相違箇所だけを読む運用へ変わります。
製造・サプライチェーン:発注量と時期の判断と、契約条件の照合
需要データの収集、在庫レベルの確認、サプライヤーとの契約条件の参照を経て、発注量と時期を判断する運用が該当します。発注そのものは取り消しが効かないため、実行には人の承認を挟む範囲に置きます。
サプライヤー契約条件の照合は、価格改定や納期変更があったときに、現行契約との差分を出す使い方です。条件変更の交渉は人が引き取ります。
データ分析・経営企画:KPIの変動要因の分解と、会議資料の生成
数字が動いた事実は見えていても、要因の分解と次の打ち手までに日数がかかる、という状態がよく起きます。KPIの変動要因の分解は、データ分析AIエージェントが担う代表的なユースケースで、この距離を縮めます。複数のデータソースを横断して候補となる要因を挙げ、仮説が外れれば条件を変えて調べ直します。構造化された行動データと、レビューやコメントのような文章のままのデータをどう扱うかは、SNS感情分析とは?KPIより先に動く読み方、日本語の誤判定、ツール選定の基準で整理しています。
部門横断の会議資料の生成も対象になります。各部署が別々のデータソースから資料を持ち寄ると、数字のすり合わせで時間が終わることがあります。同一のデータソースから同じ手順で資料を生成すれば、前提の確認を飛ばして解釈の議論から始められます。
業界別に見ると、ユースケースの重心が変わる
部門が同じでも、業界によって先に立ち上がるユースケースは変わります。
ゲーム・エンタメでは、課金率や継続率が動いた要因の分解と、セグメントごとの施策の出し分けが中心になります。運営中のタイトルは数字の変化が速く、要因の説明に日数がかかると打ち手が遅れるためです。
EC・小売では、需要と在庫を見た発注判断と、レビューや問い合わせからの商品改善が中心です。構造化された購買データと、文章のままのレビューを同時に扱う必要があります。
メディア・配信では、コメントやSNSの反応を行動データと突き合わせる使い方が増えます。視聴や閲覧のログだけでは、離れた理由までは分からないためです。
金融では、取引の異常検知と、規制要件に沿った審査の下準備が対象になります。判断の経緯を後から追える記録が、他の業界より強く求められます。
製造では、設備の保全計画と、設計知見の検索が中心です。社内にしかない過去の判断理由を参照できるかどうかで、成果の幅が変わります。
業界が違っても、どの局面でどの指標を見るかという考え方は共通して使えます。数字が動いた直後に要因を分解し、次の施策へ移すという運営の進め方は、ゲームで磨かれたものがECやメディアにもそのまま当てはまります。
どのユースケースにも共通するのは、工程と工程の間が縮むこと
これまで試せる施策の数は、人数と時間で決まっていました。新しい手法が10個あっても、担当者が3人なら実行できるのは一部です。管理職の仕事の多くは、どれを試してどれを捨てるかの選別でした。複数の仮説を並行して検証できるようになると、捨てていた施策の成否が実際のデータで分かります。管理職の役割は選別から結果の解釈へ移ります。
部門間の引き継ぎも変わります。営業から企画へ、企画から営業へと業務を移すとき、人が人に説明し、相手が理解するのを待つ工程に時間がかかっていました。営業が受け取ったリード情報をそのままマーケティング自動化の仕組みに渡し、以降のアクションをAIエージェントが継続して実行する形にすれば、この待ち時間が削減されます。
会議の前提も揃います。各部署が別々のデータソースから資料を持ち寄ると、数字のすり合わせで時間が終わることがあります。これまでの業務改善は各工程の効率化に向いていましたが、AIエージェントが短縮するのは工程と工程の連携です。
浮いた時間の使途を決めないと、ユースケースの効果は消える
ここで必要な判断があります。削減された工数を新しい検証に充てると明示的に決めなければ、空いた時間は既存業務で埋まります。「楽になった」という実感で止まる企業が多いのはこのためです。経営層へ説明する際も、効率化ではなく意思決定の能力をどう強化するかという文脈で提示するほうが、次の投資判断につながります。
業界別のユースケースを事例で確認する
ゲーム、エンタメ、EC業界での活用の進め方を、導入事例として公開しています。
AIエージェントの5つのタイプと、自社がどこから始めるか
AIエージェントは自律性の度合いで5つに分かれます。高度なタイプを選ぶことが正解ではなく、自社の業務がどの段階に当てはまるかで選びます。
反射型から学習型までの5段階
反射型エージェントは、環境の状態に対して決められたルールどおりに反応します。メールが届いたら自動返信する、特定の条件を満たすデータが入力されたらアラートを出すといった、手順が完全に固定された業務が対象です。
モデルベース反射型エージェントは、過去の状態を記憶したうえで判断します。先月の売上が目標を超えたので今月は在庫を増やす、といった時系列データを参照する業務が該当します。
目標ベースエージェントから、本格的な自律性が現れます。目標を与えれば複数のステップに分解し、各段階で判断しながら進みます。「今月の新規顧客に個別の営業提案を作成する」という目標であれば、顧客データを調べ、業界動向を確認し、その企業に合わせた提案文を作成するまでを続けて実行します。
効用ベースエージェントは、複数の目標が相反する場合に最適化します。顧客満足度を高めながらコストを抑えるといった要件を同時に追う場面で、両者のバランスを判断します。
学習エージェントは、運用を通じて判断の精度を改善します。ただし真価を発揮するのは、組織側が「何が正解か」という評価基準を定義できている場合に限られます。基準がないまま運用すると、誤った方向へ学習が進みます。
高度なタイプほど良いわけではない
企業の実務では、この5つが単独で使われることはほとんどありません。反射型で運用ルールを固め、目標ベースへ移り、評価基準が揃った段階で学習型へ進むという順序が、リスクと効果の釣り合いを取りやすい進め方です。
選定の観点は3つです。手順が決まっているか。例外がどの程度の頻度で発生するか。結果を数値で評価できるか。手順が完全に決まっていて例外がない業務なら反射型で足ります。手順が決まらず都度の判断が必要な業務ほど、目標ベース型を使う価値が大きくなります。
複数のAIエージェントを組み合わせるときの設計
単一のAIエージェントに長い指示を詰め込むと、出力が期待と違った場合に原因を特定できなくなります。複数の専門エージェントが役割を分けて協働する構成は、この問題を避けるための設計です。
オーケストレーターとスペシャリストに分ける
基本の構成は、全体の目的を把握して担当を割り振るオーケストレーターと、特定の領域を担当するスペシャリストの組み合わせです。営業提案書の作成であれば、情報収集の担当が顧客データを調べ、執筆の担当が文案を作成し、校閲の担当がブランドガイドラインとの適合を確認します。複数のAIエージェントと社内システムをまたいで実行順序や権限を統制する層は、AIオーケストレーションツールと呼ばれます。
この構成の利点は、どこで間違えたかが分かる点にあります。情報収集が不十分だったのか、執筆の段階で誤りが生じたのか、校閲の判定が厳しすぎたのか。役割を分けておけば各段階の入出力が記録として残るため、改善すべき箇所を絞り込めます。
管理する側から見ると、この構造は人の組織設計とほとんど同じです。営業部に営業担当者を配置し、企画部に企画の担当者を配置するのと同じように、各エージェントに役割と責任を割り当てます。新しいスキルを習得する必要はなく、既存の組織運営の経験がそのまま使えます。
往復の上限と、渡す情報の絞り込みを先に決める
分担の粒度には注意が必要です。細かく分けすぎると引き継ぎの回数が増え、どこかで情報が落ちます。最初は3つか4つの役割から始め、運用しながら構成を調整するのが現実的です。階層を増やすほど伝言の精度が落ちるのは、人の組織と同じです。
複数のエージェントが協働する場合、往復が止まらなくなる状態への備えが要ります。執筆の担当が作成した文案を校閲の担当がポリシー違反と判定し、修正と再判定が延々と続く、という状態です。防ぐ手段は3つあります。
一つ目は、止める仕組みを先に置くことです。往復回数に上限を設定し、達したら未完成のまま人に報告する設計にします。完成しないと渡さないという考え方は、ループが続いたまま連絡が来なくなるため、事態を悪化させます。
二つ目は、渡す情報を絞ることです。調査の担当が集めたすべての情報を執筆の担当に渡すのではなく、オーケストレーターが必要な分だけを抽出して渡します。判断の材料が絞られるため、往復そのものが減ります。
三つ目は、人が確認する箇所を限定することです。最初からすべての中継点に人を置くのではなく、運用して問題が多く出た箇所に限って確認を挟みます。
複数のエージェントが力を発揮するのは、新規事業の計画書作成、複数部門が関わるプロジェクト管理、規制対応が必要な商品開発のような、多段階のプロセスです。構築そのものよりも、各エージェントが何を判断し、何を判断しないのか、失敗時に誰が責任を負うのかを事前に定める作業のほうが重要になります。
AIエージェント基盤の選び方は、業務データがどこにあるかで決まる
基盤の選定は、機能の比較表ではなく、自社の業務データがどこに存在するかという一点から始まります。この軸がぶれると、統合に工数がかかり、期待した成果も得られません。
汎用型と業界特化型は、知識の所在で使い分ける
汎用型の強みは、幅広い業務に対応できる柔軟性です。ただし業界固有のルール、規制要件、商慣習といった専門知識を持たないため、重要な判断で誤った結論に至る可能性があります。
業界特化型には、その業界の専門知識があらかじめ組み込まれています。金融機関向けであれば規制要件とコンプライアンス、医療機関向けであれば医学知識と患者プライバシーの保護が該当します。
使い分けの判断基準は、その知識が社外にあるか社内にあるかです。法令の改正、業界団体の様式変更、保険や医療の算定ルールのように業界全体で共通する知識は社外にあります。複数企業分をまとめて更新するベンダーに任せるほうが、コストと更新漏れの両面で有利です。
一方、自社の価格設定のロジック、顧客ごとの取引経緯、過去に断った提案の理由は社内にしか存在しません。これらは汎用型に自社データを統合する形でしか扱えません。特化型を選んでも、こうした社内の文脈を自動的に備えているわけではないためです。実務では、業界標準の知識は特化型を購入し、自社固有の判断基準は汎用型を基盤に構築する組み合わせが機能します。
特化型を選ぶ場合、確認すべきなのは更新の体制です。製品の更新頻度が契約に明記されているか、誰の責任で対応されるか、対応にどの程度の期間を要するか。外部知識の更新を委託できることが特化型を選ぶ理由であるため、ここが曖昧だと選ぶ意味が失われます。
自社のデータがどこに集まっているかで、候補は絞れる
市場に出ている基盤は、どの環境にデータが集まっているかを前提に設計されています。製品の優劣ではなく、自社の環境との適合で絞り込みます。
営業履歴、サポートチケット、顧客属性がCRMに集まっている場合は、そのCRMの上で動く基盤を選ぶと、データ連携の工数をかけずに運用できます。ただしCRMへの入力率が低い組織では参照できる情報が限られるため、事前にデータの品質を確認します。
メール、チャット、文書共有といったグループウェアに文書と会話履歴が蓄積されている場合は、そのグループウェアと統合された基盤が候補になります。文書作成とコミュニケーションが中心の部門と相性があります。
パブリッククラウド上で基幹システムが動作していて、自社に開発と運用の体制がある場合は、クラウド事業者が提供する基盤モデルの実行環境を使って自前で構築する選択肢があります。自由度が高い反面、設計と運用を自前で行う前提になります。
規制産業で説明責任が求められる場合は、監査ログの粒度を比較の軸に置きます。何をいつ実行したか、なぜその判断に至ったかをどこまで記録できるかで、運用できる業務の範囲が変わります。
どの基盤を選んでも、成否は製品の選定では決まりません。権限の設計、取り消せるかどうかという基準、複数エージェントを使う場合の往復上限と情報の絞り込み。これらを整理していない状態では、どの基盤でも同じ箇所で停滞します。比較の観点は、どのデータが前提か、誰が日常的に運用するか、監査ログの粒度はどの程度かという3点に絞るほうが実用的です。
自社環境から出せないデータがある場合の選択肢
顧客の個人情報、未公開のタイトル情報、取引条件のように、自社環境の外に出せないデータを扱う場合は、配置の形態そのものが選定条件になります。遮断の度合いに応じて、生成AIをクローズド環境で動かす3つの構築方式から選ぶことになります。
ThinkingAIが提供するエンタープライズ向けAI Agentプラットフォーム「Agentic Engine」は、オンプレミス型のセルフホストレイヤーとして、顧客自身の技術環境内に配置できます。この構成では顧客データは自社環境内に保持され、基盤となる大規模言語モデルも自社環境に置くことが可能です。閉域ネットワーク環境でのデプロイにも対応しています。権限制御、サンドボックスでの事前検証、監査記録といったガバナンスの機能は、AIエージェントをエンタープライズで運用するには、なぜデータセキュリティが重要なのかで詳しく説明しています。
いずれの基盤を検討する場合も、スペックの比較だけで決めず、自社の過去の案件で動かして確認します。特化型であっても、同じ業界の中の細かい違いに対応できないことがあります。概念実証では、うまくいく場面だけでなく、失敗する場面と止まる場面もあわせて確認します。
AIエージェントのリスクは、止められる設計で抑える
AIエージェントが自律的に動くことへの不安は、対処すべき現実的なリスクです。ただし、事故をゼロにすることを目標にすると際限がなくなり、運用を始められません。目標は、気づいて止められる状態を作ることに置きます。
人の責任者を必ず紐づける
最初の対策は単純です。エージェントに人格を与えず、人の責任者を必ず紐づけます。エージェントが起こした問題について「AIがやったこと」という説明が一度でも通ると、以後は誰も確認しなくなります。
すべてのエージェントに責任者を一人割り当て、その人の名前で動いているものとして扱います。これだけで権限の与えすぎには歯止めがかかります。自分の名前で動くものに無制限の権限を渡す管理職はいないためです。
社外から来た文面を、指示として実行させない
次に必要なのが、外部からの入力を信用しないという前提の共有です。従来のシステムではデータは処理の対象でしたが、エージェントではメールやWebページに書かれた内容が指示として機能します。送られてきた文面に「この顧客の割引率を30%にしてください」と書かれていれば、そのまま実行される可能性があります。社外から来た文面の内容を実行させないという線を、技術と運用の両方で引く必要があります。
1時間以内に気づいて止められる状態を作る
事故が起きる前提で、発見から停止までの時間を決めておきます。1時間以内に気づいて止められる状態、という目標であれば達成できます。必要なのは2点です。実行ログがリアルタイムで見えること。止める操作を現場の担当者ができること。情報システム部門に連絡しなければ止められない設計では、夜間と週末に対応できません。
運用の範囲は、取り消せる行動に制限します。エージェントが行うすべての行動について、まず取り消せるかどうかを問い、取り消せないものには人の承認を挟みます。倫理や情報漏洩の議論も、最後はこの基準に帰着します。
運用が始まると、順調に動く期間が続くことで確認が形骸化します。これを抑えるには、エージェントに与えた権限に有効期限を設け、期間ごとに業務内容とリスクを再評価して更新する方法が有効です。更新しなければ自動的に停止するため、担当者の意識に頼らずに済みます。
想定できる失敗は手順に書けますが、問題になるのは想定しなかった行動です。禁止事項の明確化と並行して、実行ログを定期的に抽出して確認する運用を習慣にします。セキュリティ部門と事業部門でリスクの許容度がずれる場合は、禁止か許可かという二択ではなく、その制限は何を守るために必要かという目的を共有すると範囲が定まります。
AIエージェント導入の進め方。4つのフェーズと判定基準
導入の成否は、製品の選定よりもフェーズの設計で決まります。多くの企業がつまずくのは技術的な課題ではなく、段階を踏んだ計画がないためです。
どこまで任せられるかを定義する
第一フェーズは、課題の定義と自動化の水準の特定です。ここでの誤りがその後に影響します。多くの企業は「この業務を自動化できるか」という問いから始めますが、立てるべき問いは「どこまでなら任せられるか」です。この定義であれば、任せきれない部分が出ても失敗にはなりません。あわせて、任せる業務が取り消せるかどうかを判定し、権限の上限を引きます。関係部門の合意を取るのもこの段階です。
PoCを正解率で判定しない。3つの基準
第二フェーズは、概念実証と実行です。よくある誤りは、正解率が何パーセントに達したか、工数が何時間削減できたかで判定することです。PoCの期間中は担当者が張り付いて手直ししているため数字は良く出ますが、全社展開の段階で張り付ける人がいなくなり、運用が破綻します。
代わりに置く判定基準は3つです。一つ目は、担当者が2週間不在でも業務が止まらずに回ったか。手直しの量が本人以外でも対応できる範囲に収まっているかを確認します。二つ目は、失敗したケースについて工程単位で原因を説明できるか。説明できないなら、ログの設計か役割分担が曖昧だということです。三つ目は、すべて止めて人の手順に戻す手順が実際に試されているか。書面で用意してあるだけでは不十分で、一度戻してみて何日かかるかを測ります。
期待値の調整は、PoCを始める前に完了させます。PoCの目的を関係者全員で合意し、正解率という数字に一喜一憂しないという共通認識を作っておきます。
データは先に全部整えない
データの準備については、先に全部整えるべきだという誤解があります。これは開始を遅らせるだけです。実際に参照した範囲が、本当に必要なデータです。PoCと並行して進め、そこから優先順位をつけて整備するほうが無駄が出ません。
ただし、最低限の基準は開始前に確保します。各レコードに最終更新日が記録されていること。空欄と「該当なし」が区別されていること。この2つが混ざると、情報がないだけなのに「ない」と断定した判断が生まれます。実務で起きる誤りの多くは、数値の正確さではなく、この区別の欠落から発生しています。表記ゆれや軽微な重複は、ある程度残っていても運用できます。
第三フェーズは、外部ツールとの連携とフィードバックの仕組みづくりです。単体で動くエージェントの成果は限定的なため、他のシステムと連携させて対象範囲を広げます。あわせて、工程、事実、正解の3項目に分けた記録の方式を定め、次の改善に使う流れを作ります。
第四フェーズは、効果測定とガバナンス体制の確立です。ここでは評価軸を分けます。既存業務の安定は達成率で見て、新規の検証は実施数とそこから何が分かったかで見ます。この分離がないと、検証は後回しになります。
全社展開では、失敗事例もあわせて見せる
全社へ広げる段階では、他部門からの抵抗と過度な期待が同時に出ます。これに対しては、失敗事例を含む具体的な動作の様子を見せるのが有効です。成功事例だけを共有すると期待だけが膨らみます。失敗して止めた事例と、そのときの復旧手順をあわせて提示することで、管理が必要な道具だという理解が組織に残ります。
エンタープライズでAIエージェントが成果につながりにくい理由。Agentic Engineが重視する3つの設計思想では、この停滞がどこで起きるかを設計の観点から整理しています。
差がつくのは、判断の理由が記録されているかどうか
既製のツールを並べている企業では、数年後にログに残るのは成果物だけです。作った資料、送ったメール、実行した取引は残りますが、なぜその判断をしたのかという理由は担当者の頭の中にあり、異動と退職で失われます。
説明責任を果たすために必要な3つの記録
管理職がエージェントの判断を自分の言葉で説明するために必要な情報は3つです。
一つ目は、参照したデータの出所と取得時刻です。どのシステムの、いつの時点の値を見たかが記録されていれば、結論の正しさだけでなく、その時点でそう判断した妥当性も説明できます。時刻が必要になるのは、後になって事実が変わった場合のためです。
二つ目は、選ばなかった選択肢です。複数の案から一つを選んだのであれば、他に何があって、なぜ外したかを残します。結論だけでは、検討していない場合と区別がつきません。
三つ目は、人が介在した箇所の記録です。どこまでが自動実行で、どこから人が手を入れたか。この線引きが曖昧だと、エージェントの誤りなのか人の判断の誤りなのかを切り分けられません。
この3つがあれば、結果が誤っていた場合でも、判断の過程は説明できます。結論と確信度のスコアだけを渡されても、管理職は説明のしようがありません。95%という数字が示されていても、根拠が見えなければ責任を負うことはできないためです。
言語化した判断基準は、新しい事業で効いてくる
記録の差が最も表れるのは、新しい事業や新しい市場に出るときです。既存のやり方を言語化できていない企業は、新しい領域で一から試行錯誤を始めます。判断基準が言語化されている企業は、どの基準が業界に固有で、どれが自社の普遍的な考え方かを切り分けられます。移せるものと移せないものが明確なため、立ち上がりの速度が変わります。
採用と育成でも差が出ます。新しく入った人が過去の判断理由を読める状態かどうかで、戦力化までの時間が変わります。習熟期間が短くなるというより、ベテランが新人を教える時間から解放され、より難しい課題に時間を使えるようになります。
ただし、この優位性は自動的には手に入りません。権限設計の見直し、構造化した記録、ログの設計、評価軸の分離、複数エージェントを運用する際のルール化。いずれも短期の数字には表れない作業です。数年後の差は、どのツールを選んだかではなく、この作業を何年続けたかで決まります。
AIが人の仕事をすべて引き受けるという期待も、仕事が奪われるという不安も、どちらも現実とは離れています。実際に残るのは、AIが扱える対象を人が意識的に増やしていく仕事です。違和感を捉え、新しい基準として言語化し、エージェントに渡す。このサイクルが回る限り、人の役割はなくなりません。
労働人口の減少に対してAIエージェントが有効な手段になるかどうかも、使い方次第です。工数削減として扱う企業は数年後に頭打ちになります。組織の判断基準を言語化し、それをAIが扱える形に更新し続ける組織は、生産性を高め続けられます。検討を始める段階で取りかかれるのは、製品の比較ではなく、自分の部署の判断基準を一つ書き出すことです。どのような状況で、どのような値を見て、どのような判断をするのか。その業務ロジックが一本言語化できたとき、組織はAIエージェントを使う準備に入ります。
自社だと、どこまで任せられるか
対象の業務と、可逆・不可逆の線引きを一緒に整理します。
よくある質問
AIエージェントのユースケースにはどのようなものがありますか
部門別に整理すると、マーケティングの月次レポート作成とキャンペーン運用、営業の名刺処理と次のアクション提案、カスタマーサポートの一次対応とFAQ更新、バックオフィスの経費精算と契約書確認、製造・サプライチェーンの発注判断と契約条件の照合、データ分析・経営企画のKPI要因分解と会議資料の生成が代表的です。いずれも、人が人に依頼して結果を待つ工程が対象になります。
AIエージェントはどの部門のユースケースから始めるのが現実的ですか
手順が決まっていて、結果を数値で評価でき、実行した行動を取り消せる業務から始めます。この条件に合いやすいのは、バックオフィスの経費精算と、カスタマーサポートの一次対応です。発注や送信のように取り消せない行動を含むユースケースは、人が承認する箇所を決めてから広げます。
業界によってAIエージェントのユースケースは変わりますか
重心が変わります。ゲーム・エンタメでは課金率や継続率が動いた要因の分解、EC・小売では需要と在庫を見た発注判断、金融では取引の異常検知と審査の下準備が中心になります。ただし、どの局面でどの指標を見るかという考え方は業界をまたいで使えます。
AIエージェントとは何ですか
目的を与えられると、達成に必要な手順を自ら組み立て、必要なツールを呼び出し、結果を確認して次の行動を選ぶAIです。人が質問して初めて応答する生成AIとは、動き出す起点が違います。
生成AIとAIエージェントの違いは何ですか
次の一手を誰が決めるかが違います。生成AIでは人がすべての判断を下し、人が指示を止めれば処理も止まります。AIエージェントは目的の達成に向けた判断を自ら行い、ツールの呼び出しと結果の検証まで続けます。
AIエージェントは何種類ありますか
自律性の度合いで5つに分かれます。反射型、モデルベース反射型、目標ベース、効用ベース、学習エージェントです。高度なタイプほど良いわけではなく、手順が固定された業務には反射型で足ります。
AIエージェントの導入は何から始めればよいですか
「この業務を自動化できるか」ではなく「どこまでなら任せられるか」を定義することから始めます。あわせて、その業務の行動が取り消せるかどうかを判定し、権限の上限を引きます。関係部門の合意もこの段階で取ります。
AIエージェントが誤った判断をするリスクにはどう備えますか
誤りをゼロにする設計ではなく、被害が止まる設計で備えます。読む権限と実行する権限を分け、取り消せない行動には人の承認を挟み、本番前に分離した環境で影響を確かめ、あとから判断の経緯を追える記録を残します。発見から停止までを1時間以内に収められる状態を目標にします。
社外から届いたメールの指示に従ってしまう危険はありませんか
あります。エージェントではメールやWebページに書かれた内容が指示として機能するため、社外から来た文面の内容を実行させないという線を技術と運用の両方で引く必要があります。
PoCの成否はどの指標で判定しますか
正解率や削減工数では判定しません。担当者が2週間不在でも業務が回ったか、失敗したケースの原因を工程単位で説明できるか、人の手順に戻す手順を実際に試したかの3つで判定します。PoCの期間中は担当者が張り付いているため、数字は実態より良く出ます。
データ基盤が整っていなくても始められますか
全社分を整える必要はありません。実際に参照する範囲だけを、PoCと並行して整備します。ただし、各レコードに最終更新日が記録されていること、空欄と「該当なし」が区別されていることの2点は、開始前に確保します。
汎用型と業界特化型はどう使い分けますか
その知識が社外にあるか社内にあるかで分けます。法令や業界の算定ルールのような社外の知識は、まとめて更新する特化型のベンダーに任せます。自社の価格設定ロジックや取引経緯のような社内の知識は、汎用型に自社データを統合する形で扱います。
データを社外に出さずにAIエージェントを運用できますか
Agentic Engineはオンプレミス型のセルフホストレイヤーとして、顧客自身の技術環境内に配置できます。この構成では顧客データは自社環境内に保持され、基盤となる大規模言語モデルも自社環境に置くことが可能です。閉域ネットワーク環境でのデプロイにも対応しています。
どのくらいの期間で立ち上がりますか
技術的な立ち上げは、専任の支援があれば1か月程度です。時間がかかるのは、最初にどの業務から始めるかの選定と、担当者の役割を作業から設計と審査へ移す組織側の移行です。