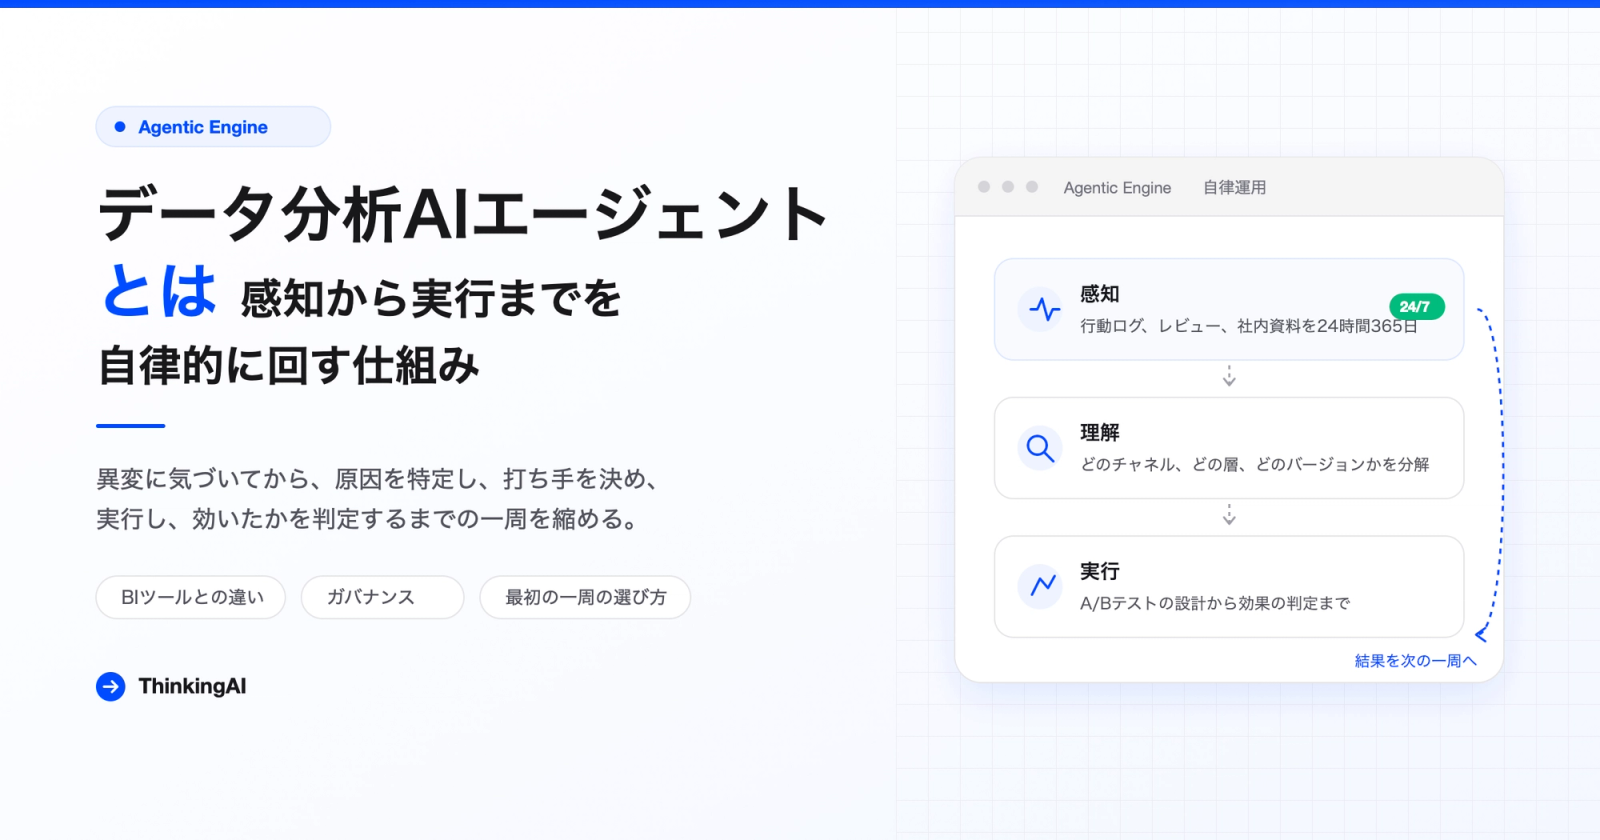
ダッシュボードを何枚増やしても、異変に気づいてから手を打つまでの日数は縮みません。感知から実行までを自律的に回すデータ分析AIエージェントは、この日数を縮めるために設計されています。
ダッシュボードが赤くなり、担当者が気づき、原因の分析を依頼し、結果を待って会議で打ち手を決める。ここまでに数日から数週間かかる運用は珍しくなく、数字を見える化する仕組みが10年かけて整ったにもかかわらず意思決定が速くならないのは、可視化の精度ではなく、人がデータに聞きに行くという工程そのものが残っているためです。
データ分析AIエージェント(データ分析AI Agent)とは、データの異変を自ら検知し、原因を分析し、打ち手の立案から実行までを自律的に行うAIのことです。人が質問して初めて動く従来のツールとは、動き出す起点が違います。
評価されるべきなのは回答の賢さではなく、異変に気づいてから、原因を特定し、打ち手を決め、実行し、効いたかを判定するまでの一周が何日で回るかという点です。一周を縮めるために何を決めておく必要があるのかを、次の4つの順序で見ていきます。
- データ分析AIエージェントの仕組み:感知、理解、実行を人の起点なしに回す
- 従来のBIツールとの役割分担:合意の場と、数字が動いたあとの区間で担当を分ける
- 権限を広げるための設計:可逆な行動は任せ、不可逆な行動には承認を挟む
- 最初の一周の選び方:気づきから実行までが同じチームで閉じる業務を1つ選ぶ
データ分析AIエージェントとは。感知から実行までを自律的に回す仕組み
データ分析AIエージェントは、感知、理解、実行の3つを自律的に回します。人が画面を開いて異変に気づくという起点そのものを、仕組みの側へ移すためです。
従来のBIツールやチャット型ツールとの違い
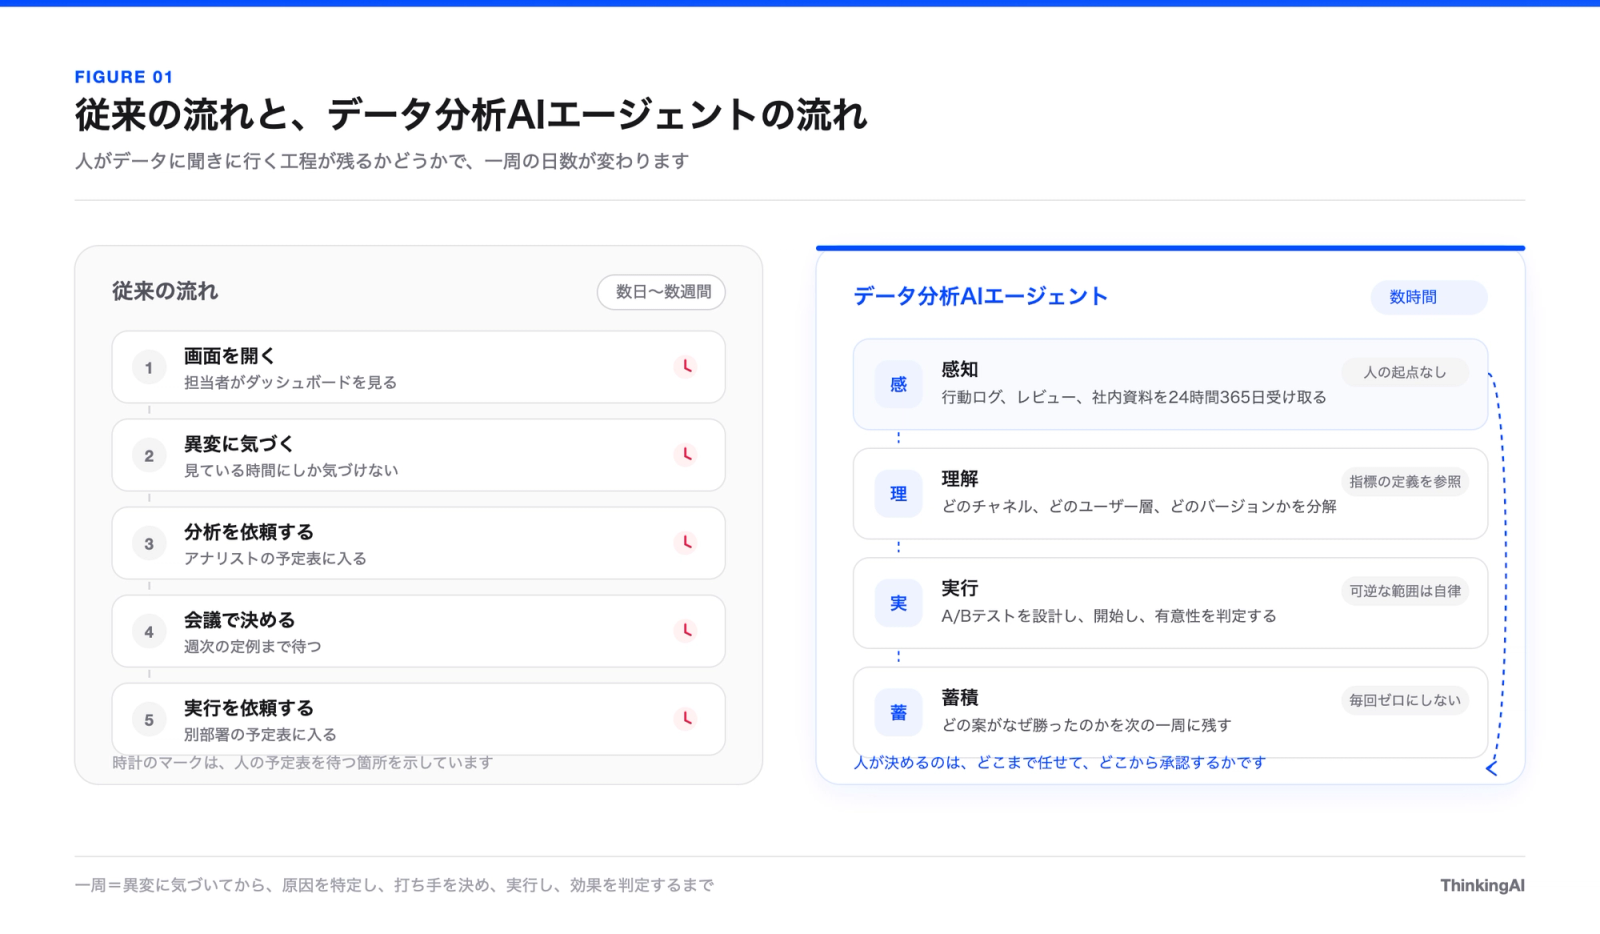
違いは、異変に気づく起点が人にあるか、仕組みの側にあるかです。従来のBIツールが解いたのは、数字を正確に見せるという課題で、これは解けています。ただし画面がどれだけ精緻でも、それを開き、異変に気づき、検証を依頼する工程は人が担います。一問一答のチャット型ツールを足しても、依頼から報告までの時間が短くなるだけで、起点は人の気づきのままであり、そもそも気づいていない問題について人が質問することはできません。
自律的に動くAIエージェントはこの起点そのものを仕組みの側へ移すもので、その動き方は3つの工程に分かれています。
感知:行動ログに加えて、レビューや社内資料まで常時受け取る
感知とは、事業を取り巻くあらゆるデータソースから、異変や機会の信号を常時受け取る工程です。ユーザー行動ログの異常だけでなく、カスタマーサポートの対話記録、アプリストアやレビューサイトに書かれた口コミ、SNSに流れたユーザーの声、過去の振り返り資料まで、構造化されていない情報も対象になり、就業時間の外でも動き続けます。
理解:どのチャネル、どのユーザー層で起きているかを分解する
理解とは、受け取った信号の背景にある原因を、自社の事業文脈で読み解く工程です。売上が落ちたという事実を受け取るのではなく、どのチャネルの、どのユーザー層の、どのバージョンで落ちているのかを分解します。ここで前提になるのが指標の定義で、継続率の数え方、先週の区切り方、収益が総額を指すのか手取りを指すのかが部署ごとに揺れていると、出てきた答えは技術的に正しくても組織に受け入れられません。ユーザー分析、継続分析、課金分析、広告分析など、各領域のSkillsを実装しておけば、その領域で何を、どの順番で分析するかをゼロから設計する必要はありません。
実行:A/Bテストの設計から効果の判定まで進める
実行とは、打ち手を立て、検証し、効果を測るところまでを進める工程です。A/Bテストの設計から開始、有意性の判定、どのセグメントにどの案が効いたのかという知見の蓄積まで進み、前回の実験で何が勝ちなぜ勝ったのかが残るため、毎回ゼロから設計せずに済みます。
意思決定のリズムは、週単位から数時間へどう変わるのか
感知、理解、実行の3つが自動で回り始めると、意思決定の間隔が会議の開催間隔から切り離されます。週次定例がある組織では、打ち手が動くのは最短で翌週でした。一周が数時間で閉じるようになると、会議は決める場ではなく、すでに回っているループの範囲と基準を見直す場に変わります。担当者の仕事も、どこまでをAIエージェントに任せ、どこからを人が承認するのかを設計することへ移ります。
Text-to-SQLとの違い:翻訳層か、実行まで含む層か
Text-to-SQLとは、自然言語の質問をSQLに翻訳するツールです。データ分析AIエージェントとの違いは、次の3点にまとめられます。
第一に、知識の持ち方が違い、Text-to-SQLが理解しているのはテーブル構造とカラム名にとどまります。データ分析AIエージェントは、自社の指標定義と業務の判断基準を、セマンティックレイヤーとナレッジグラフとして持ちます。DAUをログイン回数で数えるのかアクションを実施した人数で数えるのか、先週が暦週なのか運用週なのか、収益が総額なのか手取りなのかといった点がシステムの中に明文化されていなければ、同じ質問に別の答えが返ります。
第二に、読み取るだけか実行まで進むかが違い、Text-to-SQLは読み取り専用で、出てきた数字から打ち手を考え、実行する相手に依頼するのは人です。データ分析AIエージェントは、施策の立案と実行、効果検証までを引き受けます。
第三に、ガバナンスが運用ルールか、アーキテクチャの一部かが違います。人が最後に数字を確かめる使い方なら、事前の厳密なガバナンスは必須ではありません。人の確認を挟まずに実行する設計では、権限管理とサンドボックスと監査記録を後から足すことができないためです。
データ分析AIエージェントとBIツールの違いと、役割分担の考え方
BIツールとデータ分析AIエージェントは置き換えの関係にはありません。BIツールは組織が数字に合意する場を担い、データ分析AIエージェントは合意された数字が動いたあとの原因分析と実行を担います。
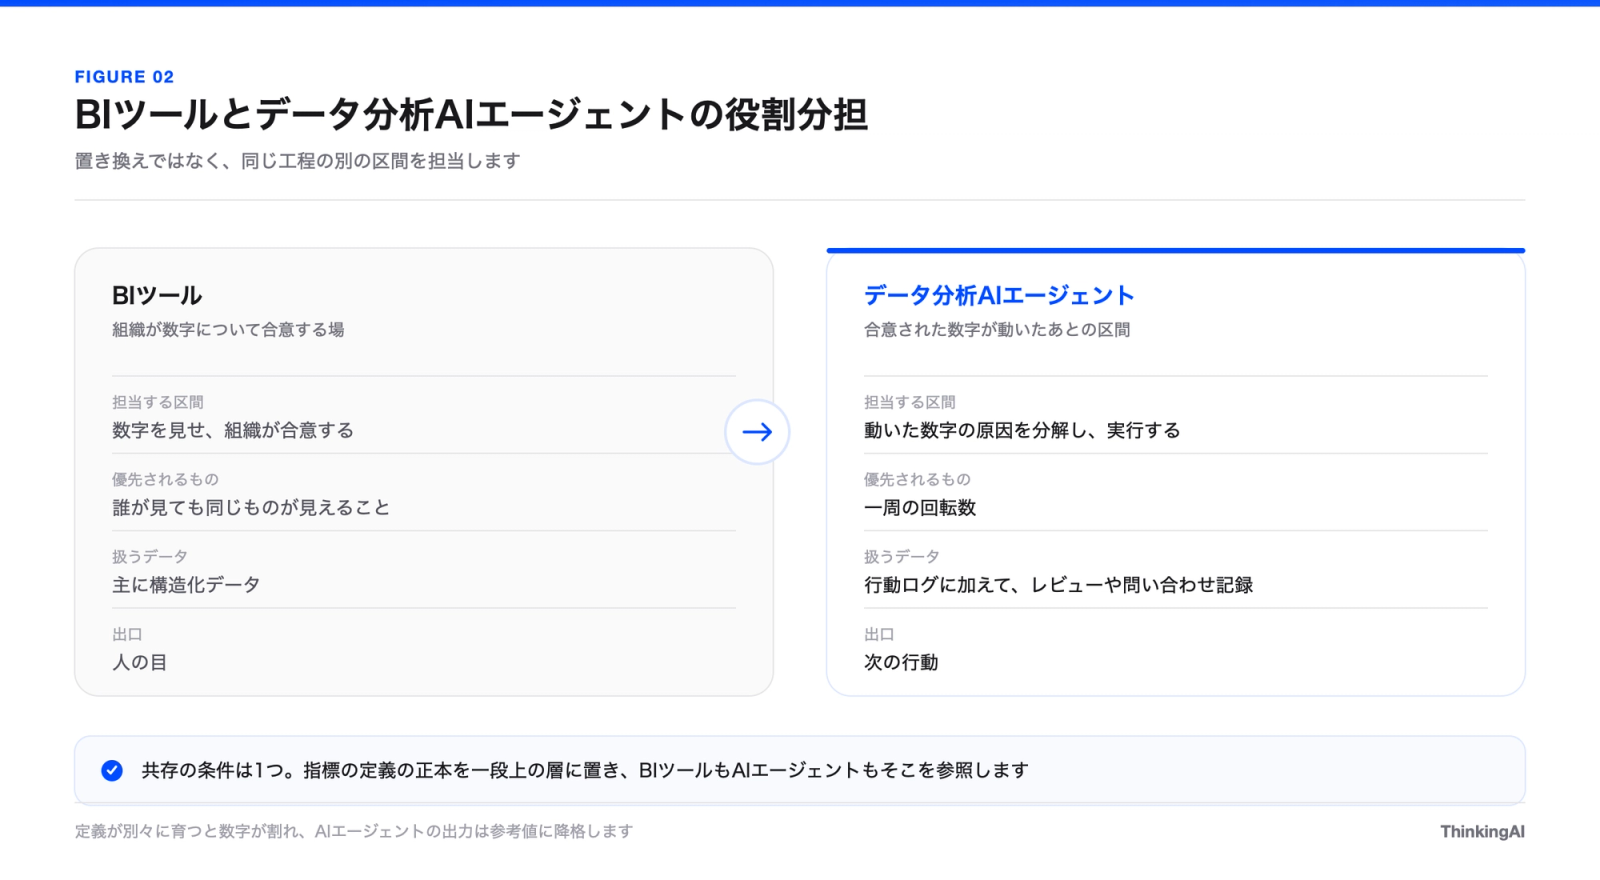
- 担当する区間:BIツールは数字を見せ、組織が合意する。データ分析AIエージェントは動いた数字の原因を分解し、実行する
- 優先されるもの:BIツールは誰が見ても同じものが見えること。データ分析AIエージェントは一周の回転数
- 扱うデータ:BIツールは主に構造化データ。データ分析AIエージェントは行動ログに加えて、レビューや問い合わせ記録
- 出口:BIツールは人の目。データ分析AIエージェントは次の行動
BIツールが担う合意の場と、AIエージェントが担う区間
BIツールが担っているのは、組織が数字について合意する場です。すでにBIツールが定着している組織では追加でAIエージェントを持つ必要があるのかという疑問が出ますが、両者は同じ工程の別の区間を担当しています。役員会で映すダッシュボード、部門間で認識を揃えるレポート、監査に出す報告書がこれにあたり、ここでは速さより、誰が見ても同じものが見えることが優先されます。AIエージェントが担うのは、合意された数字が動いたあとの区間です。なぜ動いたのかを分解し、打ち手を検証し、効いたものを広げていく区間であり、ここに合意の場は要らず、必要なのは回転数です。
役割を分けると、ダッシュボードの枚数はどうなるのか
役割を正しく分けると、BI側のダッシュボードはむしろ減ります。画面が増殖する原因は、あの指標をもう少し細かく割った画面が欲しいという依頼の積み重ねにあり、分解がAIエージェント側の処理になればBIは合意に必要な数枚で足ります。
共存の条件:指標の定義を一箇所に集約する
共存の条件は1つで、指標の定義の正本を一段上の層に置き、BIツールもAIエージェントもそこを参照する構造にすることです。この層をセマンティックレイヤーと呼び、指標の算出方法、期間の区切り方、収益の数え方をここに構造化します。定義が別々に育つと数字は必ず割れます。そして組織は例外なく、長く使われてきたBI側の数字を信じます。その瞬間にAIエージェントの出力は参考値へ降格し、一度降格した信頼は戻りません。既存のBIモデルを作り直す必要はなく、参照先を変えるだけで済むことがほとんどです。この整理自体が曖昧だった指標を洗い出す作業になるため、AIエージェントの導入可否にかかわらず組織の資産になります。
AIエージェントの出力先をどこに置くか
データ分析AIエージェントの出力先は、ダッシュボードではなく次の行動です。AIエージェントの分析結果を新しいダッシュボードとして追加すると、画面が1枚増えただけで、誰かがそれを見て、判断して、実行の段取りを組むことになり、速くなったはずの工程が人の予定表の空きに戻ります。AIエージェント間の受け渡しは、チャットの履歴ではなく、タスクと根拠と出力をまとめた構造化された形にします。複数のAIエージェントと業務システムをまたいで実行順序や文脈の受け渡しを統制する層は、AIオーケストレーションツールと呼ばれます。BIツールの出口は人の目で、AIエージェントの出口は次の行動です。
データ分析AIエージェントのガバナンスと安全性の設計
データ分析AIエージェントに権限を渡す判断は、精度では決まりません。間違いが起きたときに被害がどこで止まり、誰がいつ気づけるのかを設計で示せるかどうかで決まります。
AIが誤った判断をするリスクに、どう答えるのか
経営層の関心は、AIが誤った判断をして事業に損害を出さないか、という一点に集まります。この問いには、そのままでは答えられません。間違いをゼロにはできず、人の担当者も誤りますし、ゼロを約束する説明はその時点で信用を失うためです。答えるべき問いは、間違いが起きたときに被害はどこで止まるのか、そして誰がいつ気づけるのか、という2つになります。設計でこれに答えられるなら権限は広げられますし、答えられないなら精度がどれだけ高くても広げるべきではありません。
事前の権限設計:可逆な行動と不可逆な行動を分ける
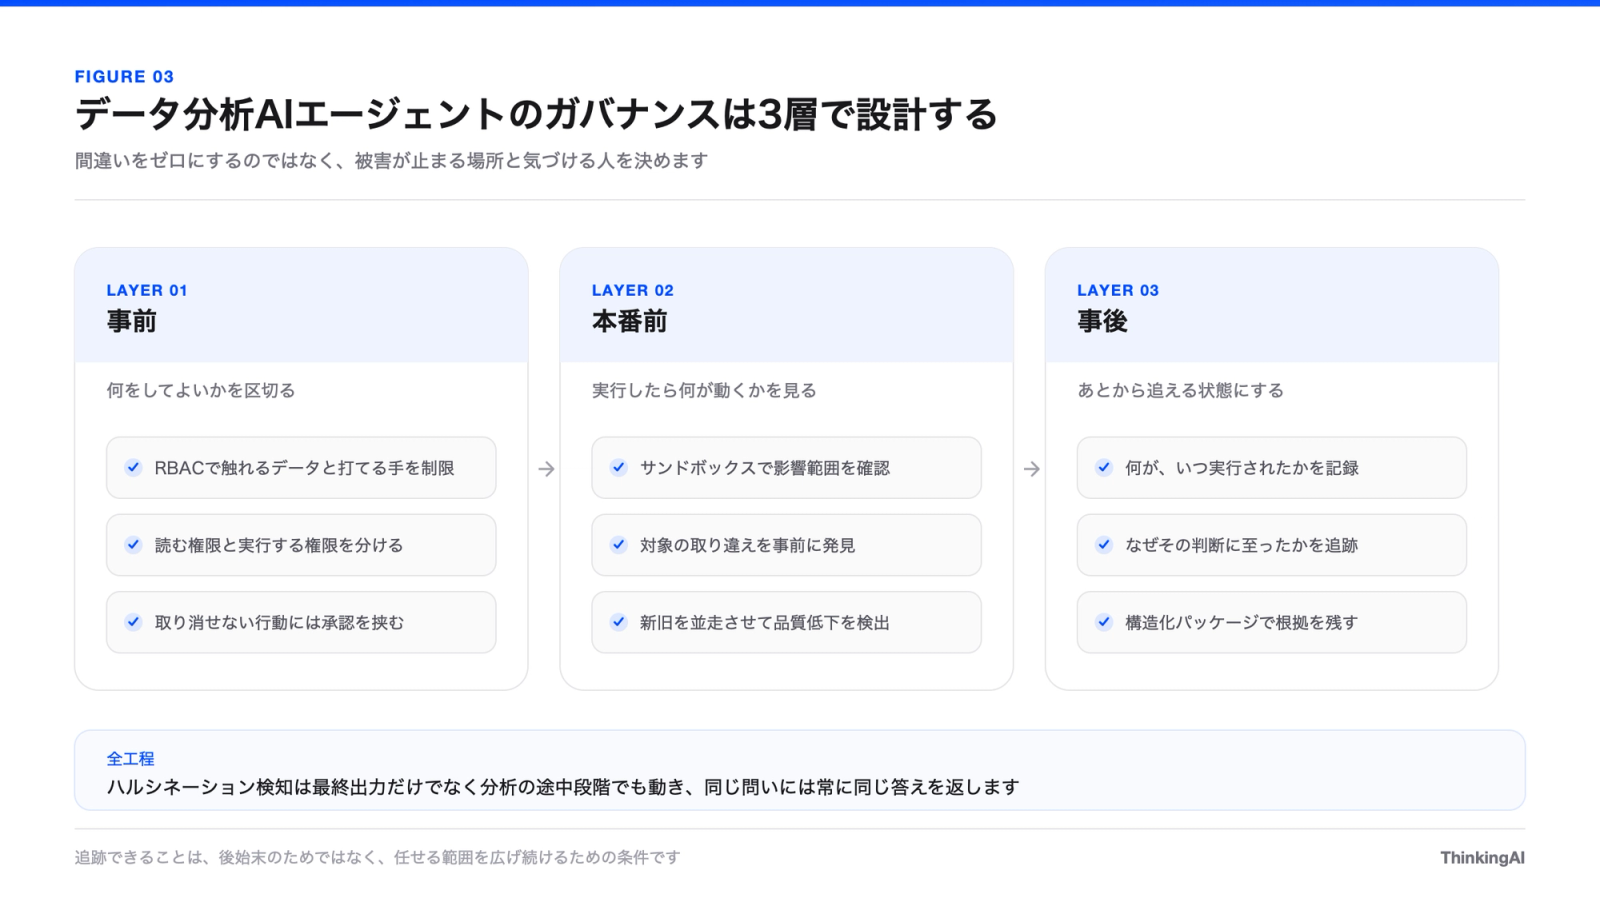
事前に決めるのは、そのAIエージェントが触れるデータと打てる手の範囲で、答えるための仕組みは3層に分かれます。事前には、RBAC(ロールベースアクセス制御)でAIエージェントごとに触れるデータと打てる手を区切り、読む権限と実行する権限を分けて設計します。承認を挟む線は、その行動が取り消せるかどうかで引きます。予算配分の変更は戻せますが、ユーザーへ送った通知は戻せません。可逆なものは任せ、不可逆なものには承認を挟むという基準であれば、現場と経営が同じ言葉で議論できます。
本番前の検証:サンドボックスとグレーリリース
サンドボックスとは、本番から分離された環境で、実行したときに何がどれだけ動くのかを事前に確かめる仕組みです。本番に出す前にこの環境で実行時の影響を確かめておくと、自律的な運用で実際に多い、判断の誤りより対象の取り違えのほうを先に見つけられます。セグメント条件が想定より広く全ユーザーに配信される、あるいはテスト用の条件が本番に残っているといった事象は、分析精度とは無関係に起きるためです。グレーリリースとは、新旧のAIエージェントを並走させ、比較してから全面展開する出し方です。並走させて比べれば、更新による静かな品質低下も全面展開の前に見つけられます。
事後の追跡:監査記録が果たす役割
事後には、何が起きたか、いつ実行されたか、なぜその判断に至ったかを追える記録を残します。記録がないと、事故のたびに権限を狭めるしか対処がなくなります。追跡できることは、後始末のためではなく、任せる範囲を広げ続けるための条件です。
データ分析AIエージェントの導入ステップと、最初の一周の選び方
データ側の準備は、全社分を完成させてから始める必要はなく、最初に一周させると決めた業務の範囲だけで足ります。整えるのは、指標の定義が1つに決まっていること、行動のログがチャネル、バージョン、ユーザー層に割れる粒度で残っていること、非構造化データの所在を把握していることの3つです。3つ目については全部をつなぐ必要がなく、接続は後から増やせます。
最初に選ぶ業務の条件
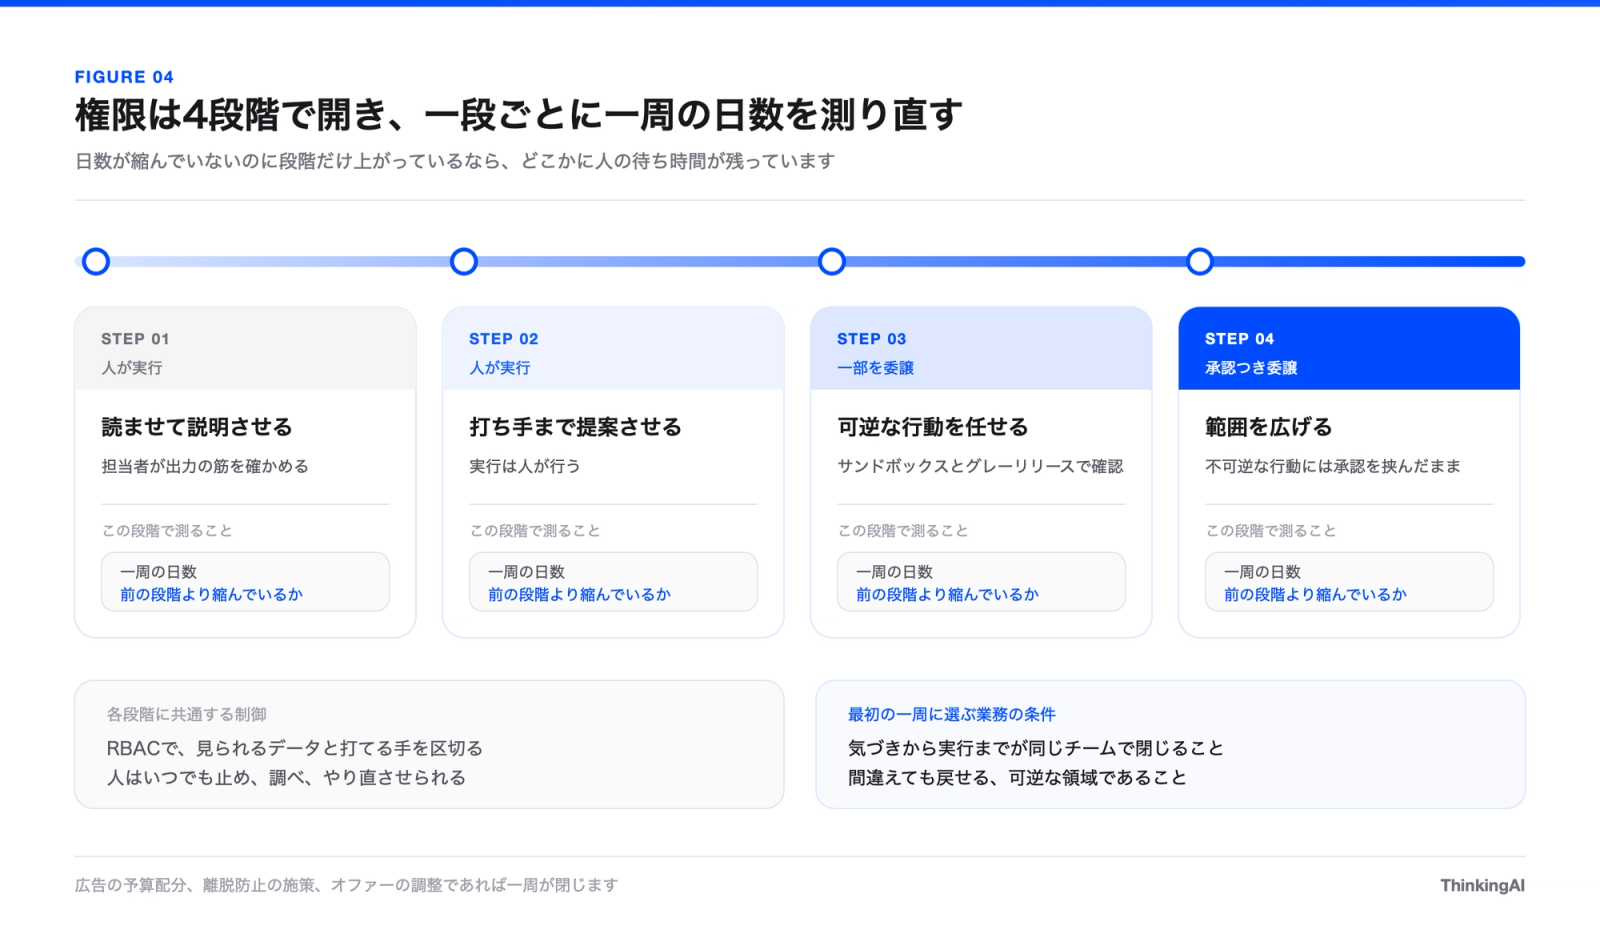
最初の一周に選ぶ業務の条件は、気づくところから実行するところまでが同じチームで閉じること、そして間違えても戻せる可逆な領域であることの2つです。分析はできても実行が別部署という業務を選ぶと、原因が分かった時点で相手の予定表待ちになります。広告の予算配分、離脱防止の施策、オファーの調整であれば一周が閉じます。始める前に現状の日数を測っておくことも欠かせません。
権限を4段階で開いていく進め方
権限は、読んで説明させるだけの段階、打ち手の提案まで任せて実行は人が行う段階、可逆な行動だけを任せる段階、範囲を広げつつ不可逆な行動には承認を挟んだままにする段階という4段階で開きます。一段上げるたびに日数を測り直せば、段階だけが上がっている状態に気づけます。その場合は、どこかに人の待ち時間が残っていることになります。
立ち上げ期間と、アナリストの役割の変化
技術的な立ち上げは専任の支援があれば1か月程度です。時間がかかるのは立ち上げではなく、最初の選定と組織側の移行です。アナリストの役割は、依頼された分析をこなす作業から、分析の方法論そのものを設計し、出力の筋を審査する側へ移ります。この合意を先に取っていないと、工数削減が自分の仕事の削減として読まれ、現場が使わないという形でプロジェクトが止まります。
Agentic Engineの提供形態とセキュリティ対応
Agentic Engineは、企業向けAI Agentプラットフォームとして、既存のデータ基盤の上に載る層を顧客自身の環境内に置く設計です。基盤を作り直す必要はなく、セルフホスト構成ではデータを自社環境の中に留めたまま運用できます。情報管理の体制、継続的な運用、技術的な設定という異なるレイヤーでセキュリティを捉え、ISO 27001、SOC 2 Type II、CIS Benchmarkに対応しています。
企業が最初に決めるべきは、どのツールを買うかではありません。最終的にどこまで任せる前提で、いまから定義と権限を整えておくか。この問いへの答えが、その後の進み方を決めます。
感知から実行までを、1つの基盤で回す形
権限を4段階で開いていく進め方と、サンドボックス、監査記録の持ち方を製品紹介資料にまとめています。
よくある質問
データ分析AIエージェントとは何ですか
データの異変を自ら検知し、原因を分析し、打ち手の立案から実行までを自律的に行うAIです。人が質問して初めて答える一問一答のツールとは異なり、人が気づいていない問題にも動き出します。
BIツールとの違いはどこにありますか
BIツールは組織が数字に合意するための仕組みで、データ分析AIエージェントは合意された数字が動いたあとに原因を分解し、打ち手を検証する仕組みです。担当する区間が違うため、片方がもう片方を置き換えることはありません。
Text-to-SQLのツールとは何が違いますか
Text-to-SQLは自然言語をSQLに翻訳し、人がデータに聞きに行く工程を速くします。自律的なデータ分析AIエージェントは、その工程自体を減らし、検知から実行までを引き受けます。翻訳層か、実行まで含む層かという違いです。
データ基盤が整っていなくても始められますか
全社分を整える必要はなく、最初に一周させる業務の範囲だけで足ります。整える対象は、指標の定義が1つに決まっていること、行動ログがチャネルやユーザー層に割れる粒度で残っていること、非構造化データの所在を把握していることの3つです。
AIが誤った判断をして事故を起こす心配はありませんか
間違いをゼロにはできないため、被害が止まる設計で答えます。読む権限と実行する権限を分け、取り消せない行動には承認を挟み、本番前に分離環境で影響を確かめ、あとから判断の経緯を追える記録を残します。
効果はどの指標で測ればよいですか
質問回数や実行した施策数ではなく、一周の日数で測ります。異変に気づいてから、原因を特定し、打ち手を決め、実行し、効果を判定するまでに何日かかっているか。開始前に測り、権限を一段開くたびに測り直します。
どのくらいの期間で立ち上がりますか
技術的な立ち上げは専任の支援があれば1か月程度です。時間がかかるのは、最初にどの業務から始めるかの選定と、アナリストの役割を作業から設計と審査へ移す組織側の移行です。
どの業務から一周を回すのがよいですか
気づくところから実行するところまでが同じチームで閉じる業務を1つ選びます。広告の予算配分、離脱防止の施策、オファーの調整であれば一周が閉じます。あわせて、間違えても戻せる可逆な領域から始めます。分析はできても実行が別部署という業務を選ぶと、原因が分かった時点で相手の予定表待ちになります。
データを社外に出さずに運用できますか
Agentic Engineはオンプレミス型のセルフホストレイヤーとして、顧客自身の技術環境内に配置できます。この構成では顧客データは自社環境内に保持され、基盤となるLLMも自社環境に置くことが可能です。閉域ネットワーク環境でのデプロイにも対応しています。
アナリストの仕事はなくなりますか
依頼された分析をこなす作業は減ります。代わりに、分析の方法論そのものを設計し、出力の筋を審査する役割へ移ります。自社が積み上げてきた判断の手順を専用のSkillとしてコード化する作業も、この役割に含まれます。属人化していた判断が言語化されるため、担当者が変わっても手順が残ります。
最初の一周を、どの業務に置くか
既存のBIとの役割分担と、権限の開き方を一緒に整理します。