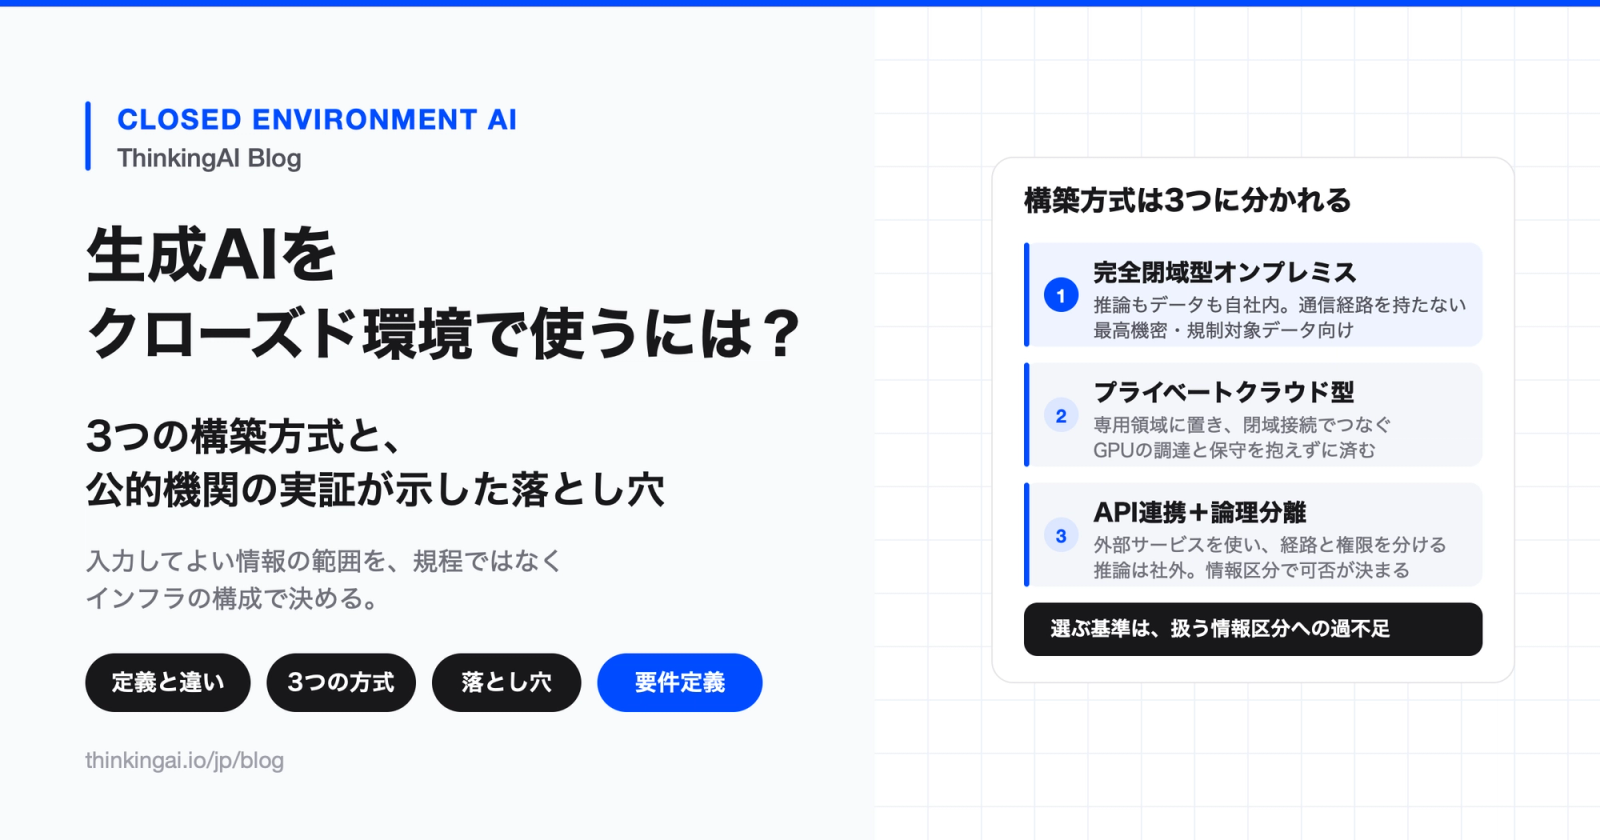
社内規程で生成AIの利用を制限しても、現場が入力したい情報は減りません。クローズド環境とは、入力してよい情報の範囲を規程ではなくネットワークとインフラの構成で決める方法です。
生成AIのクローズド環境とは、インターネットから遮断した自社の管理下にモデルと推論環境を置き、入力したデータも生成された結果も社外に出さずに完結させる構成のことです。禁止の線を引き直すのではなく、禁止しなくてよい場所を作るという考え方になります。
ただし、閉じれば安全になって終わり、という話ではありません。警察庁が公開している実証報告を読むと、閉域で生成AIを動かす作業の大半は、セキュリティ設計ではなく依存関係とモデルの持ち込みに費やされています。構築の難所は、検討段階ではほとんど見えないところにあります。
この記事では、次の順序で整理します。
- 定義と成立条件:どこまで閉じればクローズド環境と呼べるのか
- 検討される理由:総務省の調査に出ている、日本企業の懸念と停滞
- 構築方式:完全閉域、プライベートクラウド、API連携+論理分離の3つ
- 実際に起きること:警察庁の実証報告から見た5つの落とし穴
- 要件定義の順序:情報区分から決める4ステップ
- 成果を出す条件:チャットで終わらせないための接続
生成AIのクローズド環境とは、外部ネットワークから切り離した自社管理下でAIを動かす形態です
クローズド環境の生成AIとは、大規模言語モデルの推論と、そこに入力する業務データを、外部ネットワークから遮断した自社の管理領域内で完結させる構成を指します。判断の基準は3つあります。推論が行われる場所、データが保存される場所、そして通信が社外に出るかどうかです。
「完全に切断する」だけがクローズド環境ではありません
遮断には物理的な分離と論理的な分離があります。専用のスイッチとネットワークを分ける物理分離に対して、VLANや仮想ネットワークで経路を区切るのが論理分離です。どちらを選んでも、AIが動作するゾーンから外向きの通信を原則として拒否できていれば、クローズド環境の要件は満たせます。
実務では、全社のネットワークを閉じる例はほとんどありません。扱う情報の機密度が高い業務だけを閉じたゾーンに置き、一般的な業務は従来どおり外部サービスを使う構成が一般的です。閉じる範囲は、組織単位ではなく情報区分単位で決めることになります。
オンプレミス、プライベートAI、閉域の言葉を整理します
検討の場では複数の言葉が同時に出てきます。指しているものが少しずつ違うため、比較表を作る前にそろえておくと議論が短くなります。
- オンプレミス:サーバーの設置場所を指します。自社の建物やデータセンター内に機器を置く形態です
- 閉域ネットワーク:通信経路を指します。インターネットを経由しない接続の状態です
- プライベートAI:運用の考え方を指します。専用環境で自社のためだけにAIを構築・運用する方針です
- クローズド環境の生成AI:上記を組み合わせた結果の構成です。遮断された領域内で推論まで完結している状態を指します
オンプレミスであっても外部のAPIを呼び出していれば、通信は社外に出ます。逆に、クラウド上の専用領域であっても、閉域接続で経路を閉じていればクローズド環境として扱えます。設置場所と通信経路は別の論点です。モデルの重みを自社の機材に置き、推論まで内側で完結させるオフラインAI(ローカルLLM)の構成は、この2つを同時に閉じた形にあたります。
クローズド環境が検討される理由は、禁止と利用の板挟みにあります
日本企業が閉じた環境を検討する直接の理由は、生成AIの利用が広がった一方で、懸念の中身が情報漏洩に集中しているためです。これは感覚ではなく、公的な調査に数字として出ています。
日本企業が挙げる懸念の1位は、社内情報の漏洩です
総務省の令和8年版 情報通信白書によると、生成AIの活用に関して懸念されるリスクとして、日本では「社内情報の漏洩などのセキュリティリスクがある」と回答した割合が最も高く、次いで出力結果の精度、著作権等の権利侵害が続いています。
利用そのものは急速に広がりました。同白書の生成AIの業務利用状況では、自社の何らかの業務で生成AIを利用していると回答した割合は日本で86.4%です。活用方針についても、「積極的に活用する方針である」と「活用する領域を限定して利用する方針である」の合計が68.9%で、前年度調査の49.7%から大きく上昇しています。企業規模別では大企業74.0%、中小企業58.1%です。
使う企業は増えた。一方で、懸念の中心は漏洩のまま動いていない。この2つが同時に起きている状態が、クローズド環境が検討される背景です。
ガイドラインを整備しても、使えるデータは増えません
同じ白書のリスク対策に関する調査では、日本で最も多い取り組みは「全社的な指針やガイドラインを整備している」で41.1%でした。これは対策として正しい一方、効果の範囲は限られます。入力してよい情報の線引きを文書で示すだけでは、線の内側にある情報は使えないままだからです。
差が出ているのはこの点です。白書の組織的な取組状況によると、米国・ドイツ・中国では「生成AIに社内データを学習させたり、生成AIが参照可能なデータベースを構築したりしている」との回答が5割を超えており、日本はこれを大幅に下回っています。日本では「組織的な取組はない」が27.0%で、他の3か国に比べて顕著に高い水準です。
生成AIの出力品質は、モデルの性能だけでは決まりません。自社の製品仕様、過去の議事録、顧客対応の履歴にどこまで参照させられるかで変わります。規程による制限は漏洩を防ぎますが、参照範囲も同時に狭めます。クローズド環境が解こうとしているのは、この二択です。
法令側も、入力したデータの扱いの確認を求めています
個人情報保護委員会は2023年6月に生成AIサービスの利用に関する注意喚起を公表しています。個人情報取扱事業者に対して、個人情報を含むプロンプトを入力する場合は特定された利用目的の達成に必要な範囲内であることを十分に確認すること、そして本人の同意なく個人データを含むプロンプトを入力し、それが応答の出力以外の目的で取り扱われる場合は法に違反する可能性があることを挙げ、サービス提供事業者が入力データを機械学習に利用しないことなどを確認するよう求めています。
外部サービスを使う限り、この確認は利用規約とベンダーの運用方針に依存します。クローズド環境は、確認で担保していた部分を構成で担保する方法だと言えます。
構築方式は3つ。遮断の度合いと運用負荷のどちらを取るかで決まります
クローズド環境の作り方は、大きく3つに分かれます。どれが優れているかではなく、扱う情報区分に対して過不足がないかで選びます。
完全閉域型オンプレミス
自社のデータセンターや社内に GPU サーバーを設置し、オープンな重みのモデルを配置して、外部との通信を遮断する構成です。推論もデータ保存も社内で完結し、通信経路が存在しないため、情報が外部へ渡る経路自体がなくなります。
機密性が最も高い情報区分に適しています。一方で、ハードウェアの調達、モデルの更新、障害対応までを自社の責任範囲として抱えることになります。
プライベートクラウド(VPC)型
クラウド事業者の専用領域にモデルを配置し、閉域接続で自社ネットワークとつなぐ構成です。GPU の調達と保守から解放されるうえ、計算資源を必要に応じて増減できます。
データの所在は契約したリージョン内に限定できますが、事業者の管理領域に置かれることには変わりありません。どこまでを自社の管理と見なすかを、社内の基準に照らして判断する必要があります。
API連携+論理分離型
外部の生成AIサービスを使いつつ、送信前にマスキングやフィルタを挟み、接続経路と権限を分離して管理する構成です。初期費用が最も小さく、最新モデルをそのまま使えます。
ただし、推論は社外で行われます。クローズド環境と呼べるかどうかは線引きの問題になるため、機密区分の高い情報を扱う業務では採用しにくい構成です。
3方式の比較
- 完全閉域型オンプレミス:推論もデータの保存も自社内で完結します。初期費用は大きく、運用は自社が全て負い、最新モデルへの追従には自社での更新作業が必要です。最高機密と規制対象データに適します
- プライベートクラウド型:推論は事業者の専用領域で行われ、データは契約リージョン内に置かれます。初期費用は中程度で、運用の一部を事業者が負い、最新モデルへの追従は事業者の提供範囲に依存します。社外秘の業務データに適します
- API連携+論理分離型:推論は外部サービスで行われ、データは外部に送信されます。初期費用と運用の負荷は小さく、最新モデルへの追従は最も速くなります。公開情報と一般業務に適します
オープン型との違いは、性能ではなく「誰が制御するか」です
パブリックなクラウドで提供される生成AIと、クローズド環境の生成AIを比べるとき、出力の品質そのものはモデルの選択で決まります。構成が決めるのは、制御の所在です。
- データの管理責任:オープン型はサービス提供事業者と分担します。クローズド環境では自社が持ちます
- 入力データの学習利用:オープン型は規約と設定で確認します。クローズド環境では構成上、外部での学習が発生しません
- 参照させられる情報:オープン型は規程で制限した範囲までです。クローズド環境では社内の機密情報まで広げられます
- 応答速度:オープン型は外部通信の影響を受けます。クローズド環境では内部通信で完結します
- 監査と記録:オープン型は事業者が提供する機能の範囲です。クローズド環境では自社の基準で設計できます
- コストの形:オープン型は利用量に応じた従量です。クローズド環境では初期投資と固定的な運用費になります
判断の分かれ目は、監査を受けたときに何を証跡として出せるかにあります。外部サービスでは利用規約と設定画面が証跡になり、クローズド環境ではネットワーク構成図とアクセスログが証跡になります。金融、医療、公共、防衛関連のように、構成そのものの提示を求められる業種ほど、後者が必要になります。
クローズド環境の利点は3つ。守りだけでなく、使えるデータが増えます
利点を漏洩対策だけで説明すると、投資判断の材料としては弱くなります。実際に効いてくるのは次の3点です。
1つめは、参照できる情報の範囲が広がることです。 外部に出せないという理由でAIに渡せなかった仕様書、議事録、顧客対応履歴、障害報告を、そのまま参照対象にできます。生成AIの回答が一般論で終わるのは、多くの場合モデルの限界ではなく、参照範囲の制限によるものです。
2つめは、応答が内部通信で完結することです。 外部APIの混雑や通信経路の影響を受けません。業務システムに組み込んで大量の処理を回す用途では、この差が処理時間に現れます。
3つめは、費用の形が変わることです。 従量課金では利用が増えるほど費用が増えますが、自社環境では計算資源の上限内で使い切る形になります。全社展開を前提にするほど、見積もりが立てやすくなります。
警察庁の実証報告が示した、閉域構築で実際に起きること
ここが、検討段階では最も見えにくい部分です。警察庁が委託して実施したクローズド環境下での生成AIのオンプレミス利用環境の構築・運用に係る調査研究事業 検証報告書(令和7年3月21日、株式会社RUTILEA・株式会社コア)には、構築時に直面した課題が具体的に記録されています。公開されている一次資料として、検討の材料になります。
この事業では、警察庁のクローズド環境に NVIDIA H100 SXM を計36枚と InfiniBand スイッチを導入し、オープンな重みのモデルを運用できる環境を構築しています。報告書が挙げる課題は、ハードウェアの話ではありませんでした。
依存関係は、すべて手で解くことになります
報告書は、pip、npm、apt といったパッケージマネージャーがインターネット接続を前提としており、オフライン環境では機能が著しく制限されると指摘しています。必要なパッケージとその推移的依存関係をすべて事前に特定し、手動で持ち込む必要があります。
対応として取られたのは、オンライン環境で同一の構成を再現してから持ち込む方法です。ホストOSへ直接インストールするものは構成を再現したうえでオフラインインストールし、それ以外はコンテナイメージとして持ち込んでいます。
モデルの持ち込みで、ファイルが壊れることがあります
モデルファイルは数GBから数百GBに達し、HuggingFace などのモデルハブに直接アクセスできません。報告書には、重みをZip化して転送したところ解凍後に正常動作せず、Zip化せずに転送した場合は問題なかったという事例、ダウンロードの中断後に再取得したファイルが破損していた事例が記録されています。
転送手順そのものが検証対象になる、という点は見落とされがちです。
エラーが出ても、その場で調べられません
閉域内では Stack Overflow や GitHub のイシューを参照できず、最新の技術文書にもアクセスできません。報告書では、まず環境内のモデルにエラー内容を提示して対策案を出させ、解決しない場合はエラーを記録してオンライン環境で調査する運用が取られています。
テスト環境が閉じていないと、問題を検出できません
テスト環境がインターネットに接続されていると、本番のクローズド環境で起きる問題を事前に検出できないと報告書は指摘しています。あわせて、本番と同等の計算資源でテスト環境を用意することの難しさにも触れています。
同報告書は、こうした環境では事前準備が極めて重要であり、開発チームには高い技術力と問題解決能力が必要で、多くの場合「手探り」での対応を余儀なくされると記しています。
自社データでの追加学習は、データ量が足りないと効きません
この事業では、国会答弁のデータを用いたドメイン特化学習が試行されましたが、データ量や網羅性が不足しており、十分な効果を得るには至らなかったと報告されています。一方で、RAG(検索拡張生成)は業務知識の獲得に有効であることが確認されています。
閉域環境で自社の知識を反映させる手段として、追加学習より先に RAG を検討する根拠になる記述です。
なお同報告書は、構築したクローズド環境の生成AI利用環境について、秘匿性の高いデータを取り扱う中央省庁等のほか、高度なセキュリティが求められる民間組織においても有効であると考えられる、と総括しています。
要件定義は、情報区分を決めるところから始めます
製品の比較から入ると、選定が長引きます。先に決めるのは、どの情報を、どこまで出さないかです。
ステップ1:情報区分を3段階に分けます。 外部サービスに出してよい情報、社内に留めるべき情報、法令や契約で所在を限定される情報の3つです。この区分が、どの方式を使うかをほぼ決めます。
ステップ2:区分ごとに遮断レベルを割り当てます。 全社を一律に閉じる必要はありません。最高区分だけを完全閉域に置き、それ以外は論理分離で扱う構成が現実的です。
ステップ3:モデルの調達方針と更新の頻度を決めます。 オープンな重みのモデルを使う場合、更新は自社の作業になります。報告書でも、新しいモデルのほうが性能が向上しており、更新を続ける妥当性が確認されたと述べられています。年に何回、誰が検証して入れ替えるのかを運用設計に入れておく必要があります。
ステップ4:権限と記録の設計を先に行います。 誰がどのデータを参照でき、どの操作まで実行してよいか。閉じた環境であっても、内部からの不適切な利用まで防げるわけではありません。ロールベースのアクセス制御と実行記録は、構成と同時に設計します。
費用については、GPU サーバーの金額だけで見積もると実態から外れます。モデルの更新作業、依存関係の維持、障害時の調査、テスト環境の保持が、継続的な人的コストとして残ります。見積もりの対象はハードウェアではなく、この運用体制まで含めた総額です。
閉じた環境で成果を出す条件は、チャットで終わらせないことです
クローズド環境を構築しても、使われ方が文書作成の補助に留まるなら、投資に見合う成果は出にくくなります。白書でも、日本で活用が最も多い業務類型は「議事録・メール作成補助」で約7割でした。
警察庁の報告書も、更なる効率化には他システムとの連携が鍵であり、API連携等を活用して既存システムと直接連携できる仕組みを整備することで活用範囲を拡大できると指摘しています。閉域の内側でAIが業務システムに接続され、判断の材料を自分で集めて、実行まで進めるAIエージェントになるかどうかが分岐点になります。
ThinkingAI の企業向けAI Agentプラットフォーム「Agentic Engine」は、この接続までを含む構成として設計されています。オンプレミス型のセルフホストレイヤーとして顧客自身の技術環境内に配置でき、顧客データは自社環境内に保持されます。基盤となる大規模言語モデルも自社環境に置くことができ、閉域ネットワーク環境でのデプロイに対応しています。
扱う範囲は、データの収集と分析から施策の実行までです。売上やユーザー数、ユーザーの声の変化を Agent が検知し、原因を分析したうえで施策を立案し、実行まで進めます。権限はロールベースで制御し、各 Agent の判断と実行は監査用に記録されるため、閉域の内側であっても、何がいつ実行されたかを後から追えます。AI Agent の機能は、開発の進捗にあわせて段階的に提供してまいります。この、異変の検知から原因の分解、打ち手の実行までを一続きで回す設計は、データ分析AIエージェントで詳しく扱っています。
AIエージェントを業務で運用する際のセキュリティ要件については、AIエージェントをエンタープライズで運用するには、なぜデータセキュリティが重要なのかで詳しく扱っています。
閉域で、チャットの先まで動かす構成
自社環境に置いたまま分析から施策の実行までを回す仕組みと、権限設計、運用体制を資料にまとめています。
残る制約は、構築したあとに現れます
クローズド環境は、作った時点が完成ではありません。制約は運用の側に残ります。
モデルの更新は止まりません。オープンな重みのモデルは改良が続いており、性能を維持するには定期的な入れ替えが必要です。閉域では、その都度ここまで述べた持ち込み作業が発生します。
人材の確保も続きます。報告書が「手探り」と表現した作業を担える体制を、単発のプロジェクトではなく常設で持てるかどうかが問われます。
そして、閉じたこと自体は成果を生みません。参照範囲を広げ、業務システムにつなぎ、実際に使われる状態まで持っていってはじめて、投資の回収が始まります。構築の難易度に意識が向きやすい領域ですが、判断すべきなのは構築できるかどうかではなく、閉じた中で何を任せるかです。
よくある質問
生成AIのクローズド環境とは何ですか
大規模言語モデルの推論と入力データを、インターネットから遮断した自社の管理領域内で完結させる構成です。推論が行われる場所、データが保存される場所、通信が社外に出るかどうかの3点で判断します。
クローズド環境とオンプレミスは同じ意味ですか
違います。オンプレミスはサーバーの設置場所を指し、クローズド環境は通信経路まで含めた状態を指します。オンプレミスでも外部APIを呼び出していれば通信は社外に出ますし、クラウドの専用領域でも閉域接続であればクローズド環境として扱えます。
クローズド環境の構築方式にはどのような種類がありますか
完全閉域型オンプレミス、プライベートクラウド(VPC)型、API連携+論理分離型の3つです。推論が行われる場所とデータの所在が異なるため、扱う情報区分に応じて選びます。全社を一律に閉じる必要はありません。
社内ガイドラインを整備するだけでは不十分ですか
漏洩の抑止には有効ですが、AIに参照させられる情報の範囲は広がりません。総務省の令和8年版情報通信白書では、米国・ドイツ・中国で社内データの学習や参照可能なデータベースの構築が5割を超える一方、日本は大幅に下回っています。
クローズド環境の構築で難しいのはどこですか
警察庁の検証報告書では、依存関係の手動解決、モデルファイルの持ち込み、エラー時に技術情報を参照できないこと、本番と同等のテスト環境を用意できないことが課題として挙げられています。難所はセキュリティ設計よりも構築作業の側にあります。
自社データで追加学習させる必要はありますか
必ずしも必要ではありません。警察庁の検証では、データ量と網羅性の不足により追加学習で十分な効果を得るには至らず、一方でRAG(検索拡張生成)は業務知識の獲得に有効と確認されています。まずRAGを検討する順序が現実的です。
費用はどのように見積もればよいですか
GPUサーバーの金額だけでは足りません。モデルの更新作業、依存関係の維持、障害時の調査、テスト環境の保持が継続的な人的コストとして残ります。構築費と運用体制の両方を含めて見積もります。
閉域環境でもAIに施策の実行まで任せられますか
業務システムとの接続が設計に入っていれば可能です。Agentic Engineはオンプレミス型のセルフホストレイヤーとして顧客自身の技術環境内に配置でき、閉域ネットワーク環境でのデプロイに対応しています。実行の権限はロールベースで制御し、判断と実行の記録は監査用に残ります。
3方式のどれが自社に合うか
情報区分と既存の環境をうかがったうえで、構成の候補を絞ってご説明します。