生成AIを業務で使う企業は86.4%に達しました。それでも、設計図、原価表、未発表のタイトル情報、顧客の個人データを扱う工程だけは、いまも人の手に残っています。
総務省の令和8年版 情報通信白書によると、自社のいずれかの業務で生成AIを利用している日本企業の割合は86.4%で、2024年度調査の55.2%から大きく伸びました。ところが、同白書が企業に懸念されるリスクを尋ねた調査で日本企業が最も多く挙げたのは、「社内情報の漏洩などのセキュリティリスクがある」でした。使える業務は増えたのに、肝心の業務は止まったままです。
この記事では、その止まっている部分を動かす手段として、オフラインAI、すなわちローカルLLMを取り上げます。仕組みと使い分け、投資判断に直結するハードウェアの目安、ツールの選択肢、運用ルールとRAGの設計、そして実際に起きる運用上の難所までを順に整理します。読み終えたときに、自社でどの業務から切り出せるのかを判断できる状態を目指しています。
オフラインAIとは。外部に通信せず、自社の内側だけで推論を完結させる仕組み
情報漏洩リスクは「感覚」ではなく、すでに脅威の上位にある
クラウド型の生成AIサービスは、入力した内容が提供事業者のサーバーで処理されます。多くの法人向けプランは学習への再利用を行わないと明示していますが、それでも「社外のサーバーに一度渡している」という事実は変わりません。契約で守られる範囲と、物理的にデータが出ていかない範囲は別の話です。
この差が問題になる場面は、すでに一般論ではなくなっています。情報処理推進機構(IPA)の情報セキュリティ10大脅威 2026では、組織向けの第3位に「AIの利用をめぐるサイバーリスク」が初めて選出されました。第2位は「サプライチェーンや委託先を狙った攻撃」です。AIサービスを業務に組み込むことは、自社の情報の経路に委託先を一つ増やすことでもあります。
さらに、部門が個別に無料プランを使い始める、いわゆるシャドーAIが重なると、何がどこへ渡ったのかを後から追跡できません。総務省の白書でも、リスク対策として「全社的な指針やガイドラインを整備している」と答えた日本企業は41.1%にとどまっています。残りの約6割は、現場の判断に委ねられている状態です。
ローカルLLMは、モデルの重みを自社の機材に置いて推論する
オフラインAI(ローカルLLM)は、言語モデルのファイルそのものを自社のPCやサーバーに配置し、推論の計算も自社の機材で行う構成です。プロンプトも、参照した社内文書も、生成された回答も、外部のネットワークへ送られません。
技術的な骨格は三つです。モデルの重みファイル、それを読み込んで計算する推論エンジン、そしてモデルを載せるメモリ。クラウド型との差は性能そのものよりも、計算が行われる場所にあります。場所が自社の内側に移ることで、情報の扱いは契約の問題から設定の問題に変わります。
閉域網AIと完全オフラインAIは、守りたいものが違う
現場では、この二つが混同されたまま要件定義が進むことがあります。分けて考えると選択肢が整理されます。
- 閉域網AI:インターネットには接続しないが、社内ネットワークには接続する構成。オンプレミスのGPUサーバーに社員の端末からアクセスします。全社で使う場合はこの形が基本です
- 完全オフラインAI:ネットワーク自体から切り離された端末で動かす構成。工場の制御系、監査対応、現地調査など、持ち出し端末が外部と通信できない前提の業務で使います
- エッジでの推論:端末や装置の内部に小型モデルを載せ、その場で処理する構成。応答速度と通信断への耐性が目的で、守秘は副次的な効果です
多くの企業にとって現実的な出発点は閉域網AIです。遮断の度合いと運用負荷のどちらを取るかで決まるクローズド環境の3つの構築方式は、別の記事で整理しています。完全オフラインは、持ち出し先での利用や、監査上ネットワーク接続自体が認められない業務に絞って設計するほうが、投資も運用負荷も抑えられます。
AIエージェントをどの層に置くかという考え方は、AIオーケストレーションツールとは?単体AI、RPAとの違い、4つの層と選び方でも整理しています。
機密情報が、契約ではなく構成によって外に出なくなる
製造業の図面と原価、金融機関の取引データ、士業が扱う係争中の資料、ゲーム会社の未発表タイトルの仕様書。これらは「漏れたら困る」ではなく「社外のサーバーに置いた時点で説明責任が発生する」情報です。オフライン構成では通信が発生しないため、どこへ渡ったのかという問いそのものが成立しません。
総務省と経済産業省のAI事業者ガイドライン(第1.2版)は、AIを利用する事業者に対して、データの取得と利用の適正性を自ら確認するよう求めています。処理の場所を自社に置くことは、この確認を自社の設定ファイルと権限管理で完結させられるという意味を持ちます。
従量課金が消え、費用が資産側に移る
クラウドAPIの費用は利用量に比例します。全社で使い始めた途端に月額が跳ね上がり、使用を抑制する指示が出る。その時点でAIの活用は止まります。
ローカルLLMはハードウェアの初期投資と電力費が中心で、使用量が増えても費用は増えません。損益分岐点は業務量によりますが、数十名規模が日常的に使う前提であれば、2年から3年の保有期間で逆転する試算になることが多い構造です。費用の性格が、使うたびに増える変動費から、持っているだけで使える固定資産へ移ります。
通信が不安定な場所でも応答が返り、自社の用語をそのまま持ち込める
工場のライン、地下の設備、機内、海外出張先、災害時の対応拠点。通信が不安定な場所で、クラウド型は待つか諦めるかの二択になります。ローカルLLMは機材が動いていれば応答します。
もう一つの利点は、社内用語、製品コード、過去の議事録、設計変更の経緯を検索可能な形で持ち、質問のたびに参照させられることです。この仕組みがRAGで、オフライン構成ではその対象に機密文書をそのまま含められます。クラウド型で同じことをしようとすると、どの文書までなら外に出してよいかという線引きの作業が先に発生し、たいていそこで止まります。
AIエージェントに任せる範囲の決め方は、AIエージェントのユースケース12選|部門別・業界別の活用例と任せる範囲の決め方で部門別に整理しています。
ハードウェアとツールは、VRAMの逆算から決まる
CPU推論が実務で使われない理由は、速度ではなく待ち時間の性質にある
CPUでもローカルLLMは動きます。ただし生成速度が毎秒数トークンまで落ちると、回答が出るまで数分待つことになります。待っている間に自分で調べたほうが早い、という判断が現場で繰り返されれば、その時点で定着しません。
GPUが速いのは、同じ計算を大量に並列実行できるためです。そして並列計算の前提として、モデルの重み全体をGPUのメモリ(VRAM)に載せる必要があります。載り切らない分はシステムメモリとやり取りすることになり、速度は大きく落ちます。選定の軸は演算性能よりもVRAMの容量です。
必要なVRAMは、パラメータ数と量子化ビット数から概算できる
目安の計算は単純です。
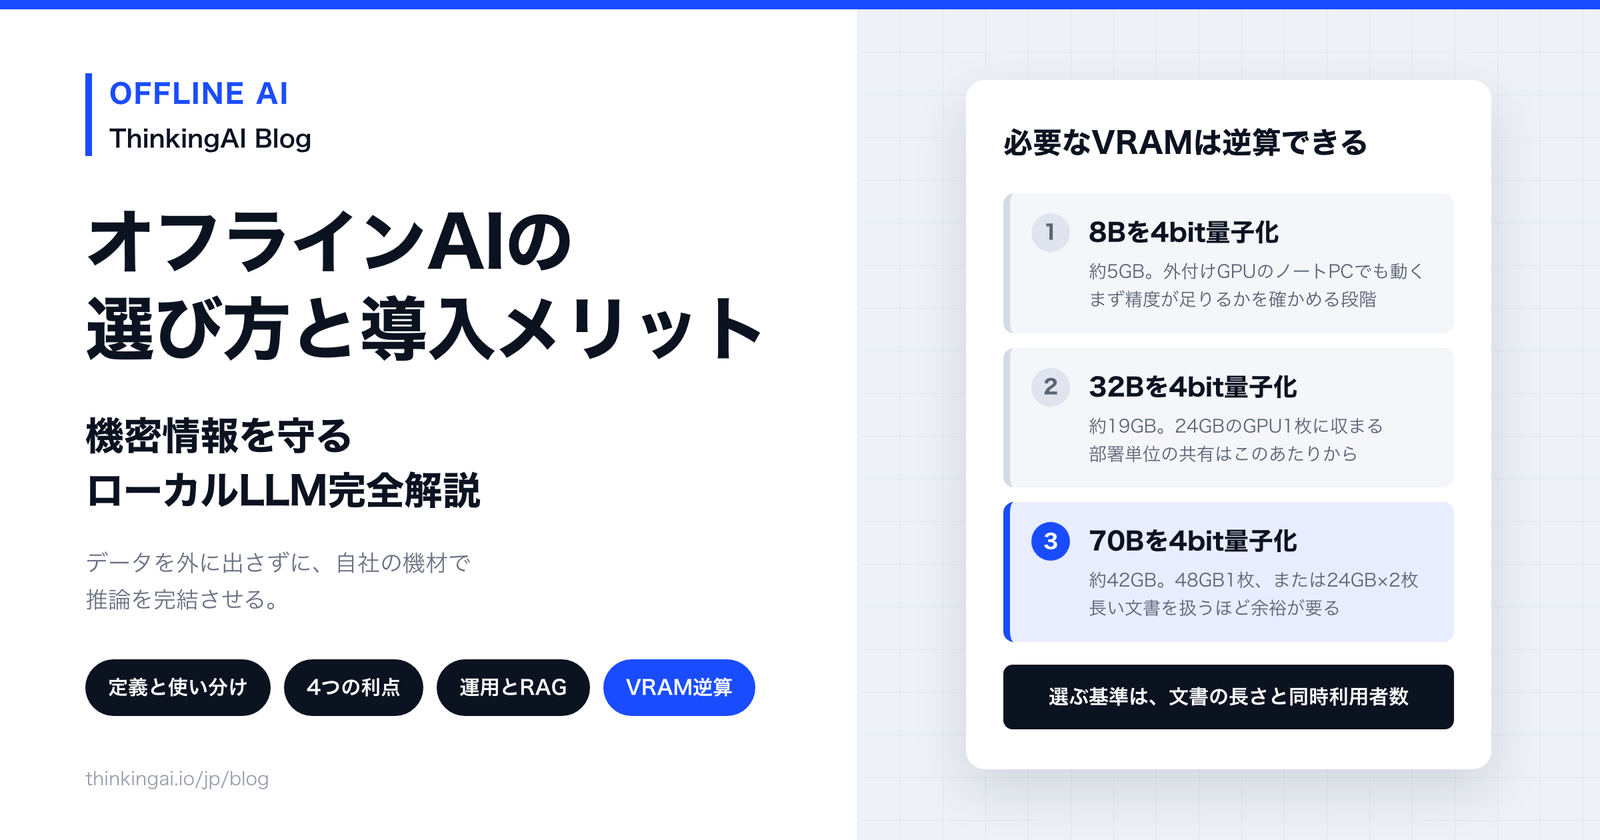
必要なVRAM(GB)≒ パラメータ数(B)× 量子化ビット数 ÷ 8 × 1.2
末尾の1.2は、KVキャッシュと実行時のオーバーヘッド分です。扱う文書が長いほどこの係数は大きくなります。
- 8Bのモデルを4bit量子化:約5GB。一般的なノートPCの外付けGPUでも動く水準です
- 32Bのモデルを4bit量子化:約19GB。24GBクラスのGPU1枚に収まります
- 70Bのモデルを4bit量子化:約42GB。48GBクラスのGPU1枚、または24GBを2枚構成にします
量子化は、モデルの重みの精度を落としてファイルサイズを縮める技術です。16bitから4bitへ落とすとサイズは4分の1になり、精度の低下は用途によっては実用上問題にならない範囲に収まります。社内文書の要約や分類が主な用途であれば、4bit量子化した中規模モデルで足ります。
規模別に、どこまでの機材が必要になるか
- 個人から数名:VRAM 24GB級のGPUを積んだワークステーション、またはユニファイドメモリ64GB以上のMac。検証と、個人業務の効率化はこの範囲で完結します
- 部署単位(20名程度):VRAM 48GB級のGPUを搭載したサーバーを社内に1台置き、閉域網で共有します。同時利用者数が増えると、生成速度ではなく待ち行列が体感を決めるため、推論エンジン側のバッチ処理設定が重要になります
- 全社規模:AI専用サーバーを複数台構成とし、推論基盤としてプライベートクラウドを組みます。この段階では、機材の調達より、どの部門のどの業務から権限を開くかという運用設計のほうが難所になります
ハードウェアの構成そのものは、要件が決まれば見積もれます。先に決めるべきは、扱う文書の長さ、同時に使う人数、そして応答が何秒までなら業務が回るかの三点です。
検証用のツール、業務特化の製品、端末内で完結する処理
機材を決める前に、どのサイズのモデルで足りるのかを確かめる段階があります。Ollamaはコマンドラインからモデルを取得してすぐ実行でき、LM Studioは同じことを画面上の操作で行えます。自社の文書を数十件読ませて要約の精度を見る作業は、投資判断の前に済ませておきます。ここを飛ばして機材を調達すると、容量が足りないか、過剰かのどちらかになります。
用途が固まっている場合は、OCRによる帳票読み取り、文書管理、議事録の自動作成といったオンプレミス製品が選択肢になります。画面から操作でき、情報システム部門の負荷が小さいことが利点です。スマートフォンやPCのチップ内で処理を完結させるオンデバイスAIは、要約や変換といった軽い処理が対象で、社内データを参照する業務には向きません。全社基盤を考える際には、選択肢ではなく前提条件として捉えるのが実態に近いと言えます。
生成した後、誰が実行するのか
ここまでの選択肢は、いずれも文章を生成するところまでを担います。生成された要約を読み、判断し、別のシステムで実行するのは人です。オフライン化によって機密の制約は外れますが、実行までの時間は変わりません。
ThinkingAIの「Agentic Engine」は、この実行までを扱う層です。異常の検知、原因の分析、施策の立案と実行までを連続した工程として設計しており、データ、モデル、推論環境をすべて顧客専用の環境に構築する個別構築に対応しています。閉域ネットワーク環境でのデプロイが可能で、基盤となるLLMも含めて自社環境内に置けます。生成の質ではなく、判断から実行までの経路の長さを問題にしている点が、前述の選択肢との違いです。考え方の詳細はデータ分析AIエージェントとは?BIツールとの違い、AIに任せる範囲、成果の測り方で解説しています。
動かす前に決める5つを、構成の側から見る
自社環境に置いたまま運用するセルフホスト構成と、閲覧権限の設計、操作履歴の残し方を資料にまとめています。
運用ルールとRAGの設計が、オフラインAIの成否を分ける
動かす前に決めておく5つのこと
機材を用意するより、こちらの合意形成のほうが時間がかかります。
- データの格付け:どの区分の文書までをAIに読ませてよいか。既存の文書管理規程の区分をそのまま使うのが現実的です
- 出力の扱い:生成された内容を、そのまま社外文書に使ってよいのか。誰が事実確認を行うのか
- 参照元の表示:回答がどの社内文書に基づいているかを必ず示す設定にします。これがないと、誤りに気づく手段がありません
- 運用担当者:モデルの更新、ログの確認、質問の傾向の把握を担う人を決めます。兼任でも構いませんが、不在にはしないことです
- 記録の保持:誰が何を聞き、何が返ったかを追える状態にします
総務省の白書で、組織的な取り組みがないと回答した日本企業は27.0%でした。米国の1.4%と比べると差は明確です。ツールの性能差より、この差のほうが成果に効きます。
ローカルRAGは、熟練者のノウハウを検索可能な資産に変える
RAGは、質問が来るたびに社内文書を検索し、関連箇所をモデルに読ませてから回答させる仕組みです。モデルを再学習させる必要がないため、文書を追加すればその日から反映されます。
対象として効果が大きいのは、属人化している情報です。過去のトラブル対応の記録、設計変更の判断理由、会議の議事録、図面に付随する注記。これらは検索性が低いまま放置されていることが多く、担当者が変わると実質的に失われます。オフライン環境のRAGであれば、機密区分の高い文書もそのまま対象にできます。
ただし、投入する前に文書を整える作業が必要です。版が複数ある資料、取り消された手順書、前提が変わった規程が混ざっていると、AIは区別せずに参照します。古い情報が自信を持って返ってくる状態は、情報がないより危険です。
閲覧権限を、最初から設計に入れる
立ち上げ時に最も多く起きる失敗は、全文書を一つの検索対象にまとめてしまい、誰が質問しても人事情報や経営資料が出てくる状態になることです。
防ぎ方は、文書群を部門や機密区分で分け、利用者の所属に応じて検索できる範囲を制限することです。そのうえで、誰がどの区分にいつアクセスしたかを記録します。Agentic Engineでは、ロールに応じたアクセス制御と、何がいつ実行され、なぜその判断に至ったかを追跡する監査記録をAgent管理の機能として備えています。
モデルは自動では新しくならない
クラウド型は提供側が更新しますが、ローカルLLMは自社で入れ替えます。新しいモデルが公開されたときに、検証して切り替える作業が発生します。四半期に一度、検証用の質問セットで新旧を比較する運用にしておくと、更新が属人的な判断になりません。この質問セットは、立ち上げ時に作った評価用のデータをそのまま活用できます。
すべてをオフラインにしない
一般的な調査、公開情報の要約、英文の下訳といった業務は、クラウド型のほうが速く、精度も高い場合があります。機密を含まない業務まで自社環境に寄せると、機材の負荷が上がり、オフライン化の目的だった業務の応答が遅くなります。
現実的な形は使い分けです。データの格付けを基準にして、区分の高い文書を扱う業務はオフライン、それ以外はクラウドと線を引きます。この線引きを文書化しておくことが、シャドーAIへの対策にもなります。
情報システム部門と現場の役割分担
オフライン化は情報システム部門が主導しますが、どの業務から始めるかを決められるのは現場です。片方だけで進めると、使われない基盤か、管理されていない利用のどちらかになります。
現場が無料のクラウドサービスを個別に使い始める背景には、公式に用意された手段が遅い、あるいは使いにくいという事情があります。禁止を通達するより、代替手段を先に提供するほうが実効性があります。管理職が、どの業務を公式の環境に載せるかを決め、その進捗を把握する体制を持つこと。これがガバナンスの実態です。
ユーザーの声や社外の反応をどう業務に取り込むかという論点は、SNS感情分析とは?KPIより先に動く読み方、日本語の誤判定、ツール選定の基準、および口コミ分析ツール12選|EC・店舗・SNS別の選び方と、「眺める」から「動く」へ変える5つの基準でも扱っています。
最初の一周をどこに置くか
オフラインAIの検討は、機材の比較から始めると終わりません。扱う文書のうち、外に出せないために止まっている工程を一つ選び、そこに何時間かかっているかを数えるところから始めるほうが、判断は早く進みます。その一工程が動けば、次に広げる範囲は現場が自分で決められるようになります。
最初の一周を、どの業務に置くか
自社の機材と扱うデータの範囲をうかがったうえで、現実的な立ち上げ方をご説明します。